문제
PET·CT 같은 단층 영상은 검출기가 얻은 sinogram에서 영상을 되돌려 만들어야 하는 역문제입니다. 측정이 불완전하고 잡음이 클수록 이 역문제는 불안정해지는데, 계수가 적은 PET에서 특히 그렇습니다.
기존 방식은 각각 한계가 뚜렷했습니다.
- FBP / MLEM — 잡음에 취약하거나 계산 비용이 큽니다.
- AUTOMAP · DeepPET — sinogram과 영상을 Fully-Connected Layer로 잇는데, 이 층 하나가 파라미터의 대부분을 차지합니다. DeepPET은 6,360만 개입니다. 해상도를 올리면 제곱으로 늘어나 실데이터에 적용하기 어렵습니다.
접근
FCL이 하는 일은 결국 sinogram의 어느 위치가 영상의 어느 voxel에 대응하는지 배우는 것입니다. 그런데 그 대응 관계는 Radon 변환으로 이미 알 수 있는, 기하학적으로 결정된 값입니다. 학습으로 알아낼 필요가 없습니다.
그래서 FCL을 SITL(Sinogram-to-Image Transform Layer) 로 대체했습니다. Radon 변환으로 필요한 voxel을 미리 tensor로 구성해두고, 그 위에서 point-wise convolution만 수행합니다. 학습해야 할 것은 복원에 필요한 정제뿐입니다.
파이프라인
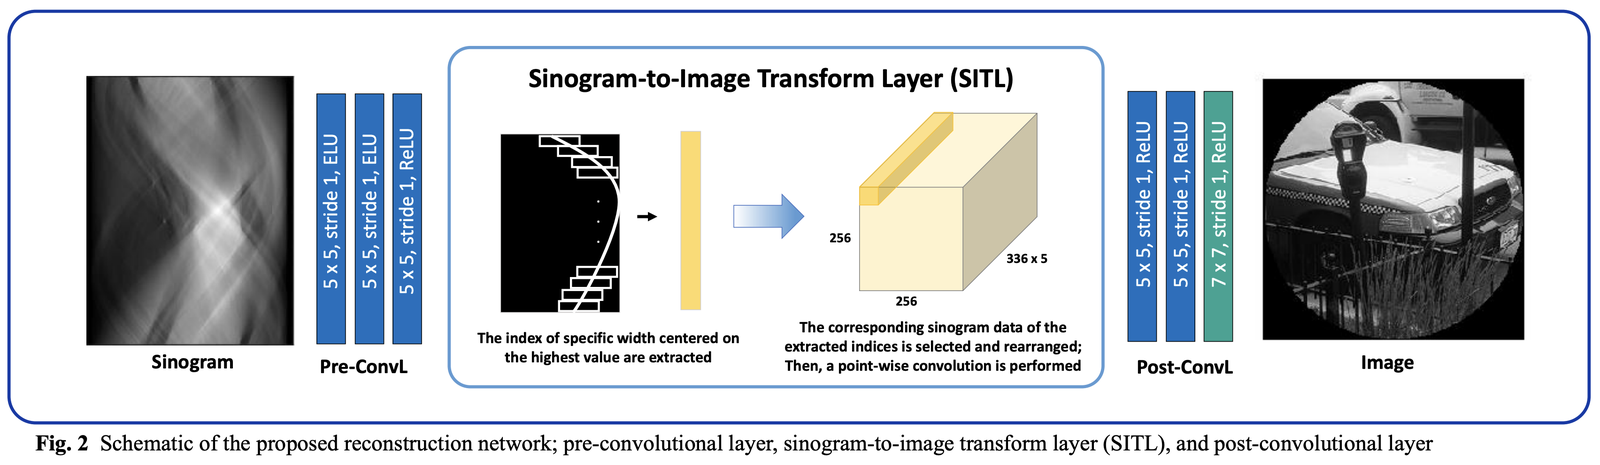 Pre-ConvL이 측정 데이터를 정제하고, SITL이 sinogram을 영상 좌표로 옮기며, Post-ConvL이 de-blurring과 de-noising을 동시에 수행합니다.
- Pre-Convolution — 측정 sinogram 정제
- SITL — 최고값을 중심으로 특정 width의 인덱스를 추출하고, 해당 sinogram 데이터를 재배열한 뒤 point-wise convolution 수행
- Post-Convolution — 복원 영상의 번짐·잡음 동시 보정
- Auxiliary loss — 중간 단계에도 손실을 걸어 학습 안정화
학습·검증 데이터는 세 경로로 확보했습니다.
- 합성 — MS COCO에 Poisson noise를 주입해 대량 학습 데이터 구성
- 실측 — 길병원에서 PET Phantom을 직접 제작·촬영해 Ground Truth 확보
- 시뮬레이션 — vGATE v7.0(Docker)으로 가상 PET 스캐너를 구현해 data acquisition 단계부터 재현
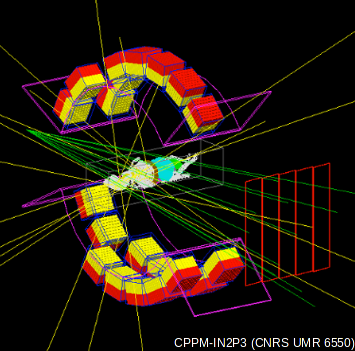 vGATE v7.0으로 구성한 검출기 링과 line-of-response. 실제 스캐너 없이 획득 단계를 재현해 검증했습니다.
결과
파라미터를 247,250개로 줄였습니다. DeepPET의 63,639,329개 대비 257배 가볍습니다. 그러면서 복원 성능은 오히려 더 좋았습니다.
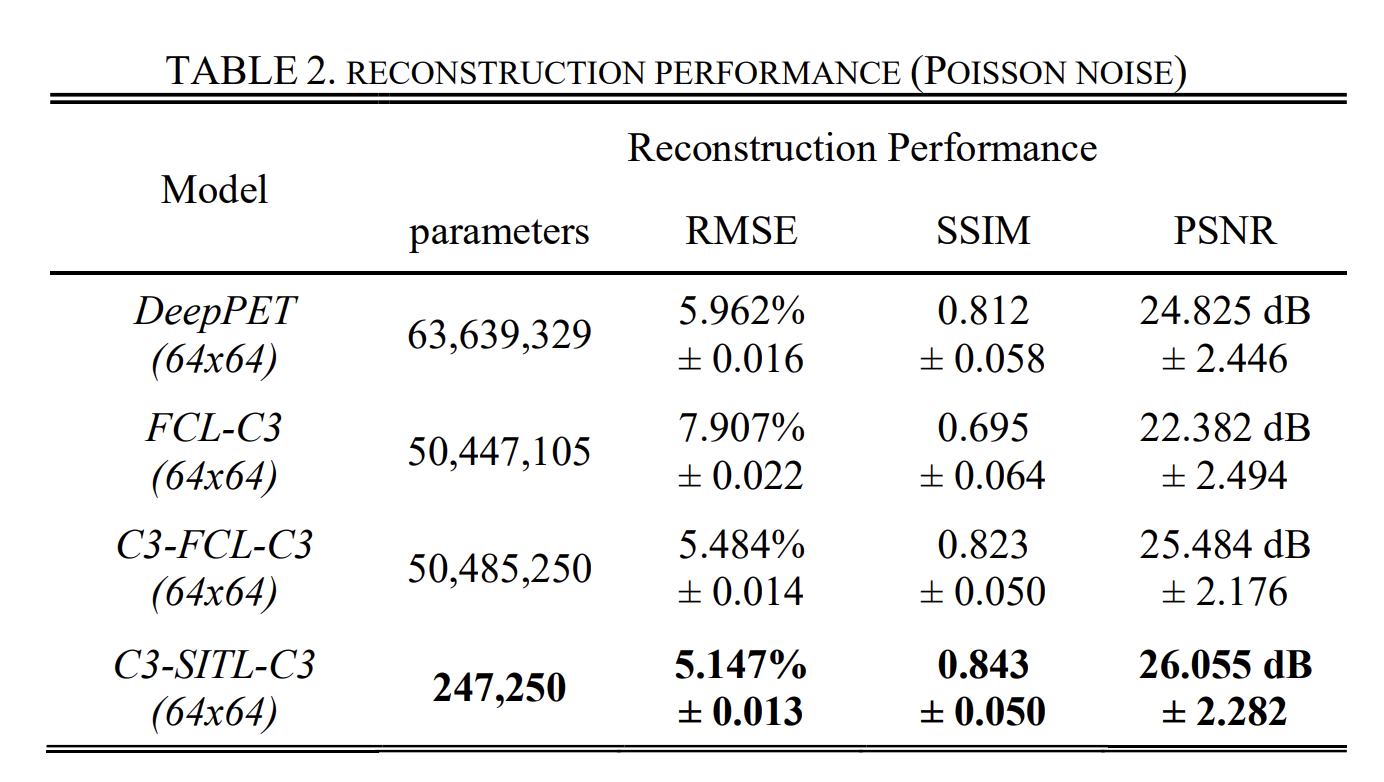 Poisson noise 조건에서의 정량 비교. C3-SITL-C3가 파라미터는 1/257이면서 RMSE·SSIM·PSNR 모두 앞섭니다.
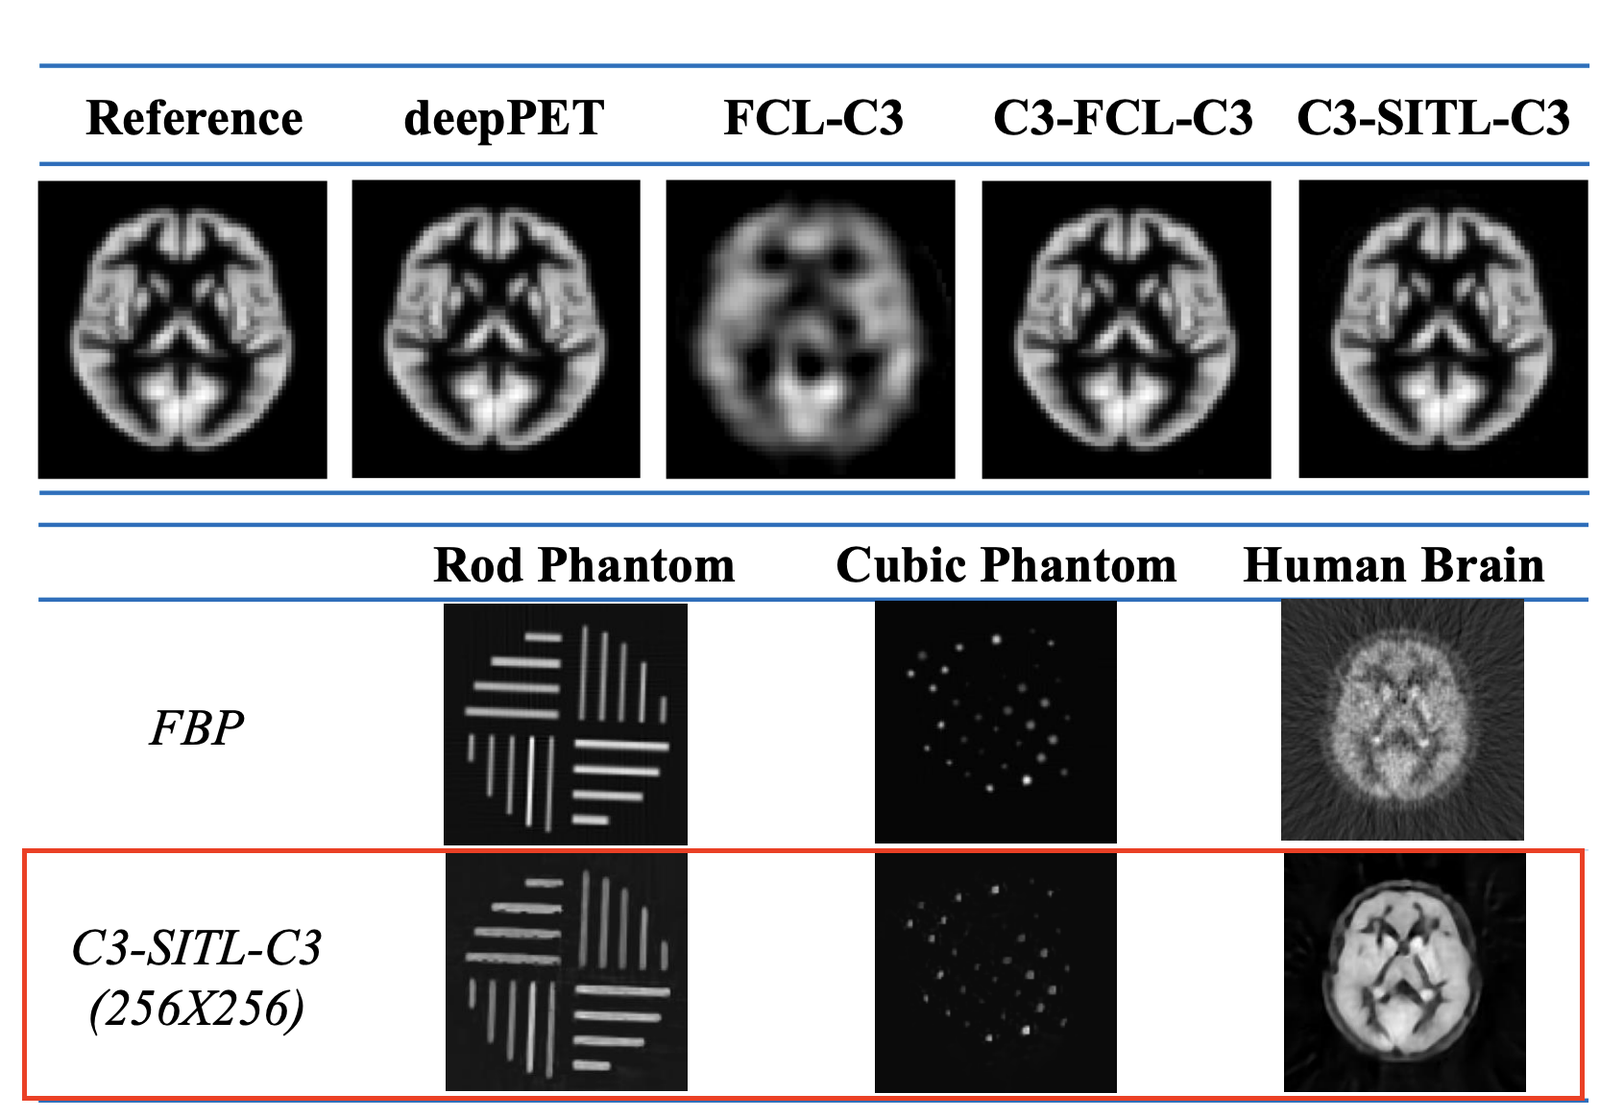 위: 모델별 복원 결과. FCL만 쓴 FCL-C3는 구조가 뭉개지는 반면 C3-SITL-C3는 reference에 가깝습니다. 아래: Rod/Cubic 팬텀과 인체 뇌 영상에서 FBP 대비 잡음이 크게 줄었습니다.
배운 점
물리적으로 이미 아는 것을 네트워크에 학습시키지 않는 것만으로 모델 크기가 두 자릿수 배 줄었습니다. 데이터로 풀 문제와 수식으로 풀 문제를 나누는 판단이 구조 설계에서 가장 큰 차이를 만든다는 것을 이 연구에서 배웠습니다.
검증을 합성·실측·시뮬레이션 세 경로로 나눈 것도 의도적이었습니다. 합성 데이터만으로 낸 수치는 실제 스캐너에서 재현되지 않을 수 있어서, 팬텀을 직접 만들어 찍고 가상 스캐너까지 구현해 같은 결론이 나오는지 확인했습니다.