PET 영상재구성 학습 데이터 만들기 — 영상에서 Sinogram까지
딥러닝으로 PET 영상을 복원하는 연구를 하려면 (sinogram, 영상) 쌍이 대량으로 필요합니다. 그런데 이 데이터를 구하는 게 생각보다 까다롭습니다.
이 글은 일반 사진으로 그 학습 데이터를 만들어내는 전처리 파이프라인을 정리한 것입니다. 딥러닝은 익숙하지만 의료영상은 처음인 분을 기준으로 썼습니다.
PET은 영상을 직접 찍지 않는다
먼저 이 분야의 전제 하나를 짚고 가야 합니다. PET 스캐너는 카메라가 아닙니다.
환자에게 방사성 추적자(tracer)를 주입하면, 대사가 활발한 조직에 더 많이 모입니다. 이 추적자가 붕괴하면서 감마선 한 쌍을 정반대 방향으로 쏘고, 몸을 둘러싼 링 형태의 검출기가 이걸 받습니다.
여기서 검출기가 알 수 있는 건 “어느 직선 경로를 따라 감마선이 하나 지나갔다” 는 사실뿐입니다. 그 직선 위의 어디에서 나왔는지는 모릅니다. 그러니 한 각도에서 얻는 정보는 영상이 아니라 그 방향으로 투영(projection) 한 값, 즉 선을 따라 다 더한 값입니다.
CNN으로 치면 입력이 이미지가 아니라 이미지를 여러 각도에서 적분한 결과만 주어지는 셈입니다. 이걸 되돌려 영상을 만드는 게 영상 재구성(image reconstruction) 이고, 정답이 유일하게 결정되지 않는 역문제(inverse problem) 입니다. 측정에 잡음이 많을수록 불안정해지는데, PET은 특히 그렇습니다.
학습 데이터가 없다는 문제
딥러닝으로 재구성을 하려면 정답 영상이 필요한데, 실제 PET에는 정답이 존재하지 않습니다. 우리가 가진 건 측정된 sinogram뿐이고, 거기서 복원한 영상은 이미 어떤 알고리즘을 거친 결과입니다. 그걸 정답으로 삼으면 그 알고리즘을 모방하는 데 그칩니다.
그래서 방향을 뒤집습니다. MS COCO 같은 일반 사진을 정답 영상으로 놓고, 물리 모델을 적용해 sinogram을 만들어내는 것입니다. 정답이 확실하고, 무한히 찍어낼 수 있습니다. 생성 모델로 학습 데이터를 늘리는 것과 비슷한 발상이되, 여기서는 생성기가 학습된 모델이 아니라 알려진 물리 법칙이라는 점이 다릅니다.
아래는 그 과정입니다. SITL 프로젝트에서 학습 데이터를 만들 때 쓴 파이프라인을 다시 정리하면서 남깁니다.
1. 영상 전처리
일반 사진을 PET 영상처럼 만드는 단계입니다.
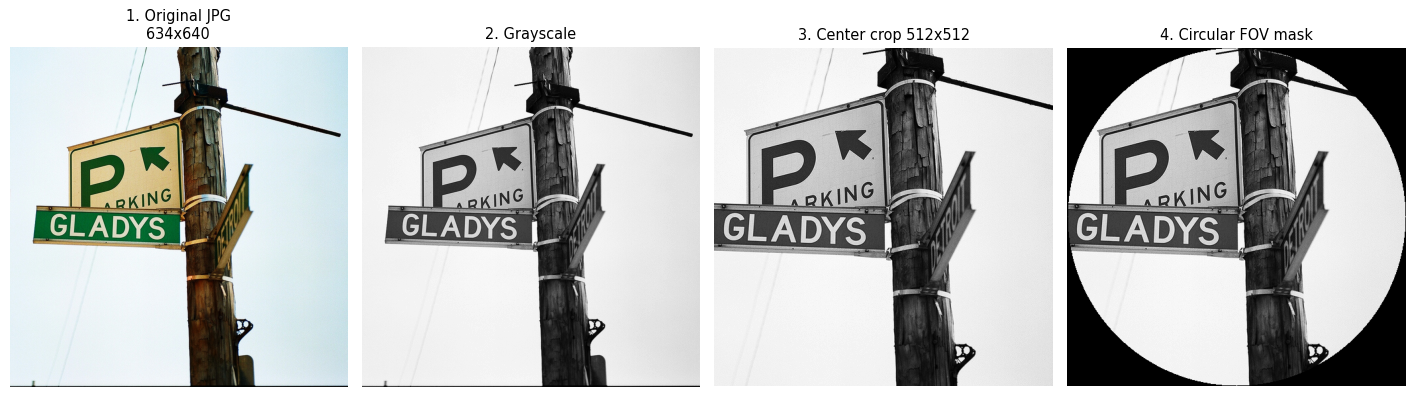 컬러 → grayscale → center crop → 원형 FOV 마스킹
핵심은 원형 FOV(Field of View) 마스킹입니다. PET 스캐너는 검출기가 링 형태로 배치돼 있어서 촬영 영역이 원형입니다. 사각형 사진을 그대로 쓰면 모서리 부분이 실제 PET에서는 나올 수 없는 데이터가 됩니다.
여기서 생각보다 중요한 게 마스킹과 정규화의 순서입니다. 포스터 본문에는 “각 영상의 평균을 뺀 뒤 전체 데이터의 최댓값으로 나눈다”고 적혀 있는데, 이대로 하면 문제가 생깁니다.
- 평균을 빼면 값이 음수가 됩니다.
- FOV 바깥이 0이 아니게 되어
radon(circle=True)전제가 깨집니다. - 무엇보다 뒤에서 넣을 Poisson 노이즈가 성립하지 않습니다. 계수(count)는 음수일 수 없으니까요.
실제로 두 방식을 비교해보니 평균 차감 방식에서는 sinogram에 음수 bin이 2,384개 생기고 노이즈 전후 총 계수가 4.48% 어긋났습니다. 단순히 255로 나누는 방식은 음수 bin 0개, 오차 0.04%였습니다. 논문 본문보다 실제 구현 코드 쪽이 맞았던 경우입니다.
2. Radon 변환 — 영상에서 Sinogram으로
PET 검출기가 실제로 측정하는 건 영상이 아니라 투영(projection) 입니다. 어떤 각도에서 몸을 통과한 감마선의 총량이죠. 이걸 모든 각도에 대해 쌓은 것이 sinogram입니다.
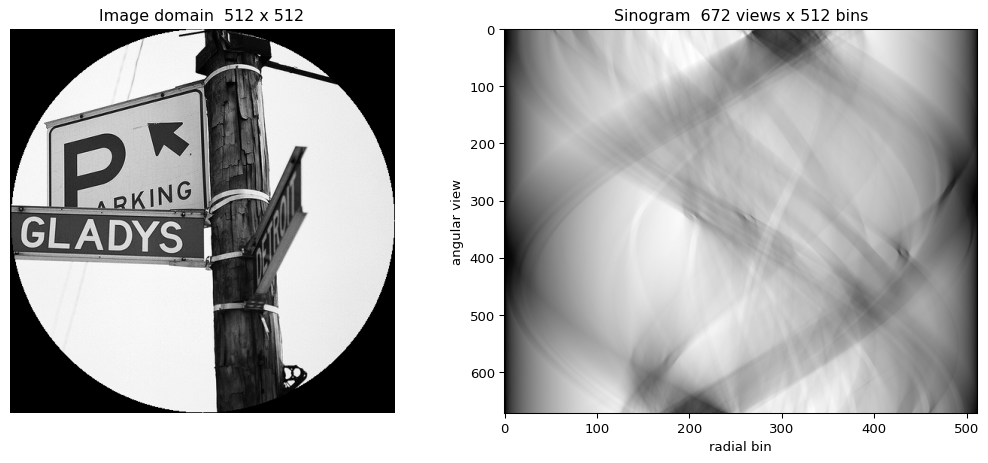 512×512 영상과 그에 대응하는 672 view × 512 bin sinogram
이 연산이 Radon 변환입니다. 모든 각도에 대해 “그 방향으로 영상을 적분한 1D 신호”를 구해 세로로 쌓으면 sinogram이 됩니다.
이름이 왜 sinogram인지는 점 하나를 넣어보면 바로 보입니다.
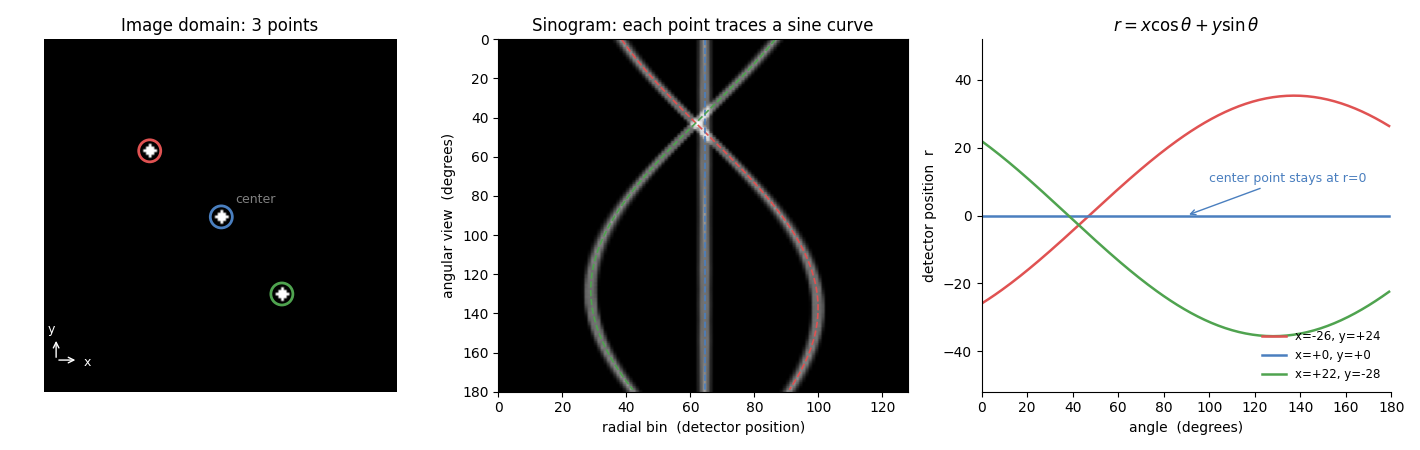 점 하나가 sinogram에서 사인 곡선을 그립니다. 오른쪽은 그 곡선을 수식으로 그린 것이고, 가운데 그림의 점선이 같은 곡선을 실제 sinogram 위에 겹쳐 그린 것입니다.
중심에서 (x, y)만큼 떨어진 점은, 검출기를 각도 theta만큼 돌렸을 때 다음 위치에 기록됩니다. 여기서 y는 수학 좌표처럼 위쪽이 + 입니다.
1
r = x·cos(theta) + y·sin(theta)
theta를 0에서 180도까지 훑으면 r이 사인 곡선을 그립니다. 그래서 sinogram입니다. 중심에 있는 점은 아무리 돌려도 r = 0이라 직선이 되고요.
numpy 배열은 행 번호가 아래로 커지기 때문에, 배열 인덱스로 좌표를 잡을 때는
y = 중심행 − 행번호로 뒤집어야 합니다. 이걸 빠뜨리면 수식 곡선이 실제 sinogram과 어긋납니다. scikit-image의radon()도 이 규칙을 따릅니다.
이게 단순한 관찰처럼 보이지만, 사실 이 분야 딥러닝 설계의 출발점입니다. 영상의 어느 픽셀이 sinogram의 어느 위치에 대응하는지가 기하학적으로 이미 결정돼 있다는 뜻이기 때문입니다. AUTOMAP이나 DeepPET은 이 대응 관계를 Fully-Connected Layer로 학습시키는데, 그래서 파라미터가 6,360만 개까지 불어납니다. 이미 아는 값을 굳이 배우게 하는 셈입니다.
축의 의미는 이렇습니다.
| 축 | 의미 |
|---|---|
| angular view (세로) | 검출기가 보는 각도. 0°~180°를 균등 분할 |
| radial bin (가로) | 그 각도에서의 검출기 위치 |
실제 PET 스캐너 기하에 맞춰 256×256 영상에는 336 view, 512×512 영상에는 672 view를 씁니다. 구현은 scikit-image의 radon()을 씁니다.
1
2
theta = np.linspace(0.0, 180.0, n_angles, endpoint=False)
sinogram = radon(img, theta=theta, circle=True, preserve_range=True).T
circle=True는 원형 FOV 안쪽만 투영한다는 뜻이고, 마지막 .T는 축 순서를 (view, bin)으로 맞추기 위한 것입니다. 이 전제 때문에 1단계의 마스킹이 정규화보다 먼저 와야 합니다.
3. Poisson 노이즈 — 실제 PET에 가깝게
여기까지 만든 sinogram은 잡음이 전혀 없는 이상적인 데이터입니다. 실제 PET은 다릅니다.
앞에서 검출기가 감마선을 하나씩 받는다고 했습니다. 그래서 sinogram의 각 칸에 들어 있는 값은 밝기가 아니라 그 경로로 몇 개나 들어왔는지 센 개수, 즉 계수(count) 입니다. 세는 과정이니 확률적으로 흔들립니다. 평균이 N이면 표준편차가 √N인 Poisson 분포를 따릅니다.
중요한 건 계수가 적을수록 상대 잡음이 커진다는 점입니다. 100개를 세면 오차가 10%지만 10개만 세면 32%입니다. 촬영 시간을 줄이거나 방사선량을 낮추면 계수가 줄고, 그만큼 영상이 나빠집니다. 재구성 연구가 결국 “적은 계수로도 쓸 만한 영상을 얻는 것” 을 향하는 이유입니다.
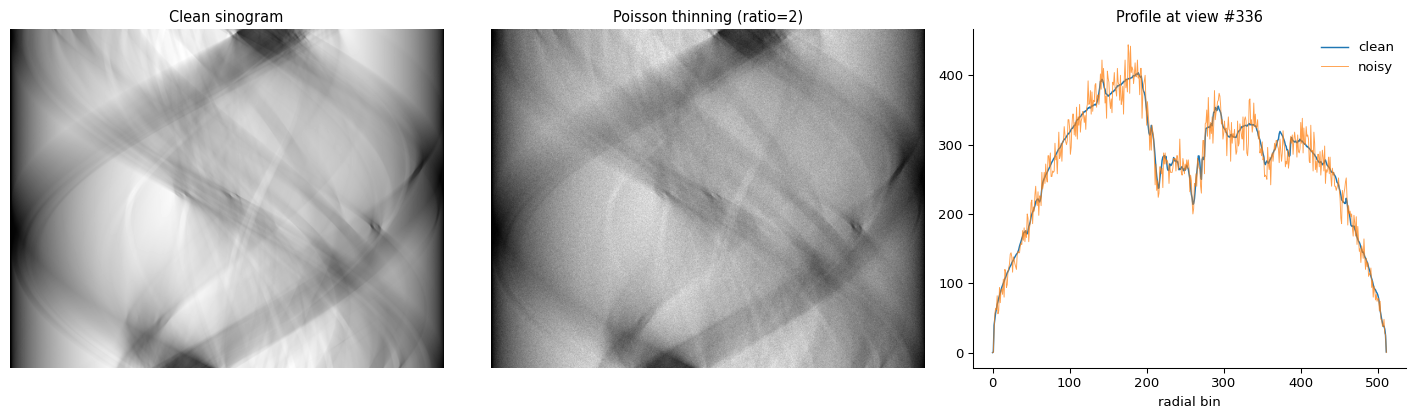 왼쪽부터 clean sinogram, Poisson thinning 적용, 특정 view의 단면 비교
적용 방식은 Poisson thinning입니다. 각 사건을 확률 1/r로 남기고 나머지를 버린 뒤 r을 곱해 원래 스케일로 되돌립니다. 저계수 촬영을 모사하는 표준적인 방법입니다.
원본 노트북은 이걸 픽셀마다 for 루프로 돌렸는데, Binomial 분포와 수학적으로 동일해서 벡터화할 수 있습니다.
1
2
3
# 원본: 픽셀마다 이중 루프
# 동일하지만 훨씬 빠름
noisy = rng.binomial(counts.astype(np.int64), 1.0 / ratio) * ratio
여기서 계수 스케일을 어떻게 잡느냐가 노이즈 강도를 결정합니다. 총 계수를 10⁶으로 맞추면 bin당 평균 11.6 counts가 되는데, 이러면 노이즈가 구조를 완전히 덮어버립니다. sinogram 값을 그대로 계수로 쓰면 bin당 약 100 counts가 되어 구조가 살아남습니다. 위 그림의 단면을 보면 잡음이 섞였지만 형태는 유지되는 걸 볼 수 있습니다.
4. 고전적 재구성 — FBP와 MLEM
딥러닝 재구성을 평가하려면 기준선이 필요합니다. 두 가지 고전 알고리즘을 같이 만들어 둡니다.
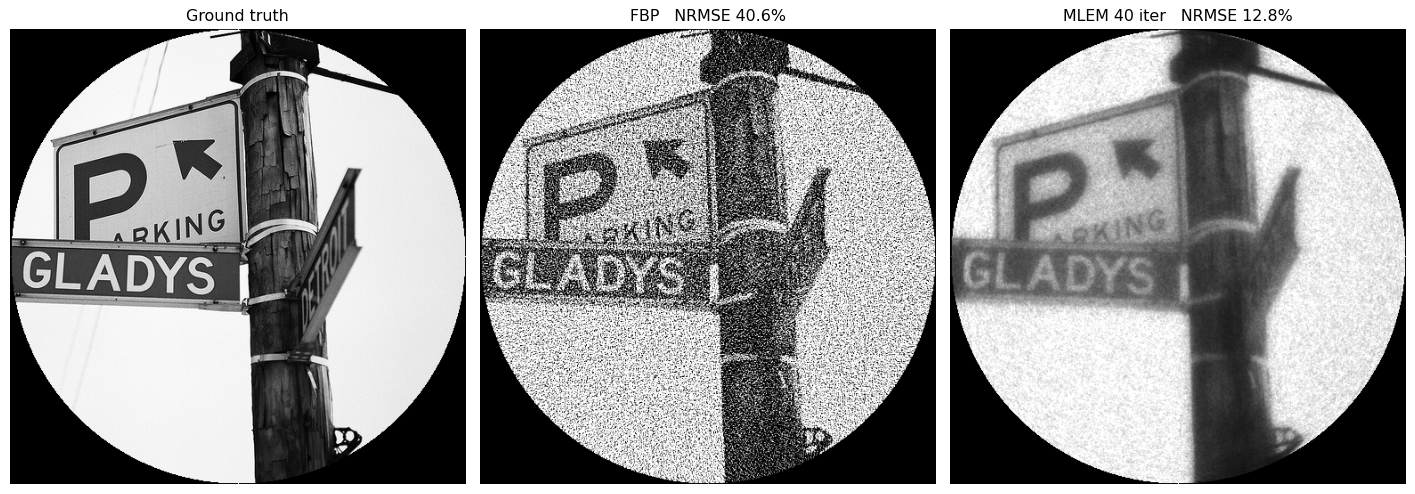 같은 noisy sinogram에서 복원한 결과
두 방법 모두 역투영(back-projection) 이라는 같은 뿌리에서 출발합니다. 어떤 각도에서 잰 투영값을, 그 직선 위 모든 픽셀에 똑같이 도로 뿌리는 연산입니다. 감마선이 그 선 위 어디서 왔는지 모르니 일단 균등하게 나눠주는 것이고, 모든 각도에 대해 이걸 반복해 누적하면 대략적인 형태가 떠오릅니다. 다만 그냥 누적하면 심하게 흐려집니다.
FBP(Filtered Back-Projection) 는 그 흐려짐을 미리 상쇄하는 필터를 씌운 뒤 역투영합니다. 이 필터(ramp filter)는 주파수가 높을수록 크게 증폭하는 형태인데, 흐려짐이 고주파를 깎아먹는 현상이라 그 역을 취한 것입니다.
문제는 잡음도 고주파라는 점입니다. 그래서 FBP는 계수가 적을수록 급격히 무너집니다. 위 그림에서 보이는 거친 입자가 그것입니다. 부수적으로 음수 값도 생깁니다 — 방사능 농도가 음수일 수는 없으니 명백한 아티팩트입니다. 대신 한 번에 끝나 빠릅니다.
MLEM(Maximum Likelihood Expectation Maximization) 은 접근이 다릅니다. “이 영상이 정답이라면 이런 계수가 측정될 확률이 얼마인가”를 Poisson 분포로 모델링하고, 그 확률을 최대화하는 영상을 반복적으로 찾아갑니다. 딥러닝으로 치면 파라미터 대신 영상 자체를 최적화 변수로 두고 gradient step을 밟는 것과 비슷합니다.
1
2
3
4
5
x_(n+1) = x_n / A^T(1) · A^T( y / A(x_n) )

    A   : forward projection (Radon 변환)
    A^T : back projection (역투영)
    y   : 측정된 sinogram
현재 추정 영상을 순투영해서(A(x_n)) 실제 측정치 y와 비교하고, 그 비율을 역투영해 보정하는 구조입니다. 잡음 모델을 명시적으로 넣었으니 FBP보다 잡음에 강합니다. 같은 데이터에서 NRMSE가 40.6% → 12.8% 로 떨어집니다. 대신 반복 연산이라 느리고, 결과가 눈에 띄게 번집니다.
NRMSE는 RMSE를 정답 영상의 값 범위로 나눠 백분율로 만든 것입니다. 영상마다 밝기 범위가 달라도 비교할 수 있게 하려는 것으로, 낮을수록 좋습니다.
MLEM에는 함정이 하나 있습니다. 반복할수록 좋아지다가 어느 시점부터 나빠집니다. 측정치에 점점 더 정확히 들어맞으려 하는데, 그 측정치에는 잡음이 섞여 있어서 결국 잡음까지 재현해버립니다. 딥러닝의 overfitting과 같은 현상이고, 대응도 같습니다 — early stopping을 씁니다.
실측한 최적 반복 횟수는 이랬습니다.
| 반복 | 5 | 10 | 20 | 30 | 40 |
|---|---|---|---|---|---|
| 64×64 | 11.57 | 10.68 | 12.81 | 15.86 | — |
| 256×256 | 13.19 | 11.19 | 9.89 | 9.82 | — |
| 512×512 | — | 18.20 | 16.22 | 15.22 | 14.66 |
해상도가 올라갈수록 최적 반복 횟수가 늘어납니다. bin당 계수가 많아져서 잡음이 상대적으로 작기 때문입니다. 반복 횟수를 고정값으로 쓰면 안 되고 데이터의 계수 수준에 맞춰야 합니다.
여기까지가 딥러닝 재구성이 이겨야 할 상대입니다. FBP는 빠르지만 잡음에 무너지고, MLEM은 잡음에 강하지만 느리고 번집니다.
5. 해상도의 현실적 제약
해상도를 올리려 할 때 부딪히는 문제도 적어둡니다. COCO는 대부분 640×480이라 짧은 변의 중앙값이 427px입니다.
| center crop | 확보 가능 |
|---|---|
| 256×256 | 4,958장 (99.2%) |
| 384×384 | 4,072장 (81.4%) |
| 512×512 | 343장 (6.9%) |
512로 가면 val2017 5,000장 중 343장만 남습니다. 업스케일하면 장수는 유지되지만 없는 해상도를 보간으로 만드는 것이라, 정답 영상이 흐려져 오히려 학습에 해롭습니다.
저장 형식에 대해
중간 결과를 .npy로 두면 512×512 기준 금방 수 GB가 됩니다. 저는 PNG로 저장하는 쪽을 택했습니다.
- 정답 영상은 원래 8-bit에서 왔으므로 8-bit PNG로 무손실입니다.
- sinogram은 계수 값이라 범위가 넓어서 16-bit PNG + 스케일 계수로 저장합니다.
1
value = png.astype(float) / 65535 * scale
왕복 오차를 실측하니 정답 영상 0.000004%, sinogram 0.0012%로 사실상 무손실이었습니다. 용량은 4.4GB에서 1.5GB로 줄었고, 무엇보다 중간 결과를 뷰어로 바로 열어볼 수 있다는 게 디버깅에 편했습니다.
정리
의료영상이 처음이라면 이것만 가져가도 충분합니다.
- PET은 영상이 아니라 투영을 측정합니다. 그래서 재구성이라는 단계가 따로 필요합니다.
- sinogram의 값은 밝기가 아니라 계수입니다. 셀수록 정확해지고, 적게 셀수록 잡음이 커집니다.
- 영상 픽셀과 sinogram 위치의 대응은 이미 정해져 있습니다.
r = x·cos(theta) + y·sin(theta). 이걸 FC layer로 학습시킬 필요가 없다는 게 SITL의 출발점입니다. - FBP는 빠르지만 잡음에 무너지고, MLEM은 강하지만 느리고 번집니다. 딥러닝 재구성이 이겨야 할 상대입니다.
파이프라인을 직접 다시 짜면서 얻은 것들도 적어둡니다.
- 논문 본문과 구현 코드가 다를 수 있습니다. 정규화 방식이 그랬고, 물리적으로 말이 되는 쪽은 코드였습니다.
- 마스킹·정규화·투영의 순서가 결과를 바꿉니다. Radon 변환의 전제와 Poisson 모델의 전제가 각각 순서를 강제합니다.
- 노이즈 강도는 계수 스케일에서 결정됩니다. 같은 알고리즘이라도 스케일을 잘못 잡으면 데이터가 못 쓰게 됩니다.
- MLEM의 반복 횟수는 데이터마다 다릅니다. overfitting과 같은 이유로, 고정값을 쓰면 손해입니다.