PET 원리 ⑧ 영상 재구성 — 직선들로부터 영상을 되찾기
6편에서 스캐너가 측정하는 건 영상이 아니라 사이노그램이라고 했고, 7편에서는 그 사이노그램에 섞인 오차를 보정했습니다. 이번 편은 드디어 사이노그램에서 영상을 되찾는 단계입니다. 이 과정을 영상 재구성(image reconstruction) 이라고 합니다.
거꾸로 푸는 문제
영상에서 사이노그램을 만드는 방향은 쉽습니다. 각 직선을 따라 값을 더하면 끝입니다. 이것을 순투영(forward projection) 이라고 합니다. PET이 풀어야 하는 건 그 반대 방향입니다. 더한 결과만 보고 원래 무엇이 있었는지 알아내야 합니다.
비유하면 이렇습니다. 여러 방향에서 비춘 그림자들만 보고 물체의 모양을 맞히는 것입니다. 그림자 하나로는 불가능하지만, 여러 방향의 그림자를 모으면 물체의 모양이 점점 좁혀집니다.
이렇게 결과로부터 원인을 거꾸로 알아내는 문제를 역문제(inverse problem) 라고 합니다. PET의 역문제는 두 가지 이유로 까다롭습니다.
- 측정값에 잡음이 많습니다. 사이노그램의 값은 Poisson 분포를 따르는 개수이고, 칸마다 몇 개~몇십 개밖에 안 되는 경우가 흔합니다.
- 잡음이 증폭되기 쉽습니다. 역문제를 순진하게 풀면 측정값의 작은 흔들림이 영상에서 크게 부풀려집니다.
재구성 방법은 크게 두 계열입니다. 수식 한 번으로 푸는 해석적 방법(FBP) 과, 추측을 조금씩 고쳐 나가는 반복적 방법(MLEM, OSEM) 입니다.
첫걸음: 역투영
가장 단순한 아이디어부터 시작합니다. 어떤 LOR에서 계수가 측정됐다면, 소멸은 그 직선 위 어딘가에서 일어났습니다. 어디인지 모르니 직선 위 모든 픽셀에 똑같이 나눠 칠합니다. 모든 LOR에 대해 이걸 반복해서 누적하는 것이 역투영(back-projection) 입니다.
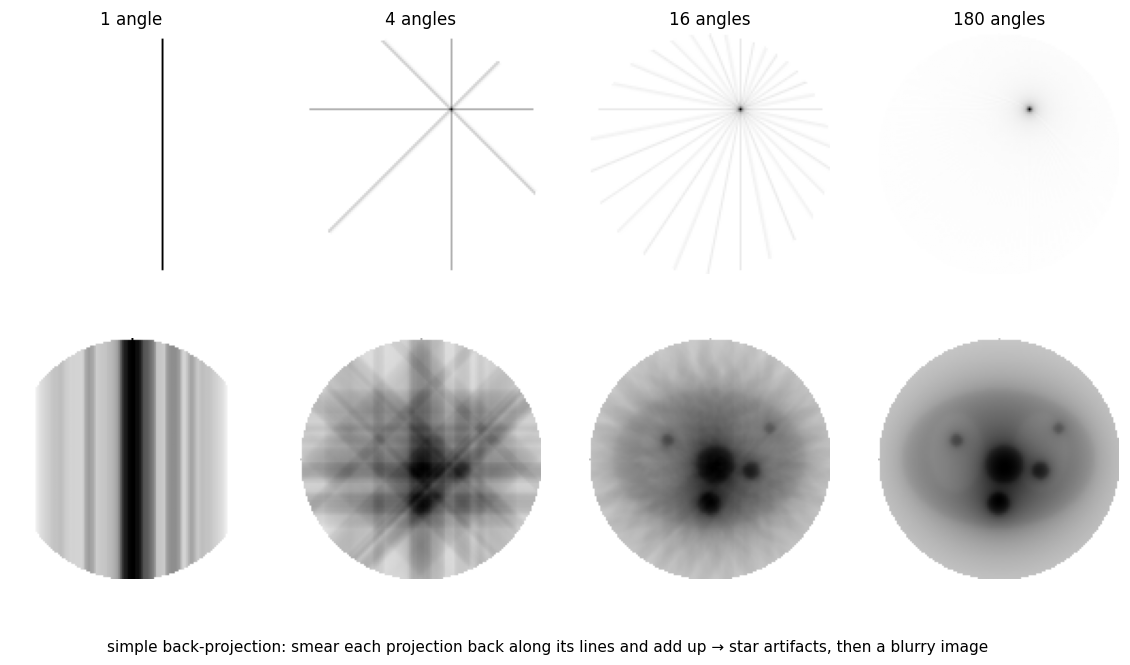 위: 점 하나. 아래: 몸통 모형. 각도가 늘어날수록 역투영 결과가 원래 모양에 가까워지지만, 여전히 흐릿합니다.
각도가 하나뿐이면 줄무늬만 생깁니다. 각도가 늘면 줄들이 겹치는 곳, 즉 방사능이 실제로 있는 곳이 진해집니다. 점 하나를 16개 각도로 역투영하면 별 모양이 되고, 180개 각도를 쓰면 별 무늬는 사라지지만 점 주변으로 번짐이 넓게 남습니다.
이 번짐은 우연이 아닙니다. 직선을 칠할 때 원래 없는 곳까지 칠했기 때문인데, 수학적으로 따지면 번짐은 중심에서의 거리에 반비례하는(\(1/r\)) 모양입니다. 역투영만으로는 원래 영상을 흐리게 만든 것밖에 얻지 못한다는 뜻입니다.
FBP: 미리 날카롭게 만들어서 역투영
번짐의 모양을 정확히 안다면, 미리 반대 방향으로 보정해 두면 됩니다. 역투영이 영상을 흐리게 만든다는 건, 주파수로 보면 고주파(세밀한 부분)를 약하게 만든다는 뜻입니다. 그러니 역투영하기 전에 각 투영에 고주파를 키우는 필터를 먼저 씌웁니다. 이것이 FBP(Filtered Back-Projection) 입니다.
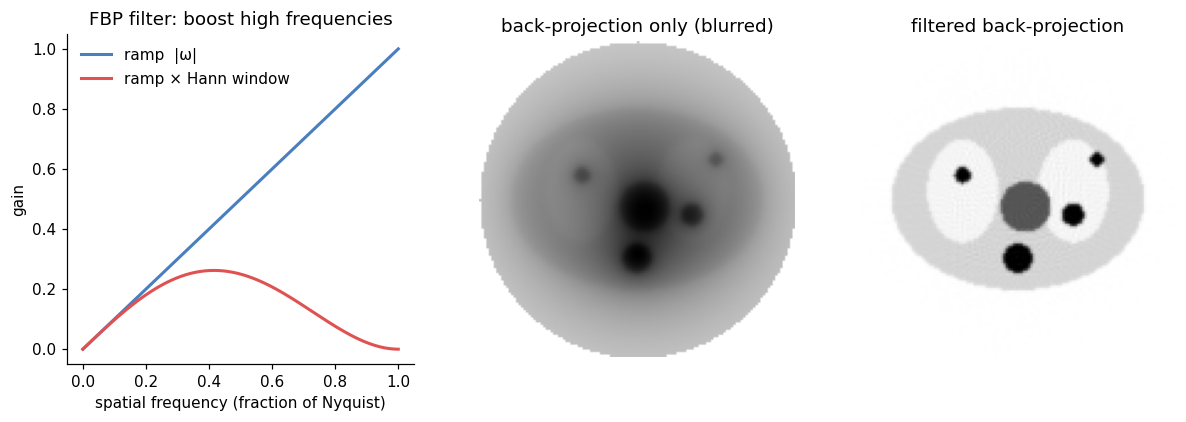 왼쪽: 램프 필터는 주파수에 비례해 증폭합니다. 잡음을 줄이려고 창 함수(Hann)를 곱해 고주파를 다시 눌러 줍니다. 가운데: 역투영만 한 결과. 오른쪽: 필터를 씌운 뒤 역투영한 결과.
잡음이 없는 데이터에서는 FBP가 정확한 답을 줍니다. 그리고 계산이 한 번에 끝나서 빠릅니다. 수십 년 동안 CT와 PET의 표준이었던 이유입니다.
문제는 잡음도 고주파라는 점입니다. 램프 필터는 고주파를 키우므로 잡음도 같이 키웁니다. 그래서 실제로는 창 함수를 곱해 고주파를 적당히 누르는데, 누를수록 잡음은 줄지만 영상이 흐려집니다. 잡음과 해상도 사이의 줄다리기입니다.
FBP는 계수가 적은 PET에서 특히 불리합니다. 음수 값과 방사형 줄무늬(streak)가 생기기 쉽습니다. 방사능 농도는 음수일 수 없으니 명백한 아티팩트입니다. CT는 광자 수가 PET보다 훨씬 많아서 FBP로도 잘 버팁니다.
MLEM: 추측하고, 비교하고, 고친다
반복적 방법은 접근이 완전히 다릅니다. 수식으로 한 번에 풀지 않고, 추측한 영상을 조금씩 고쳐 나갑니다.
- 추측: 아무것도 모르니 균일한 영상에서 시작합니다.
- 예측: “이 영상이 정답이라면 스캐너는 무엇을 측정했을까?”를 순투영으로 계산합니다.
- 비교: 예측한 사이노그램과 실제 측정한 사이노그램을 칸마다 나눠서 비율을 구합니다.
- 보정: 그 비율을 역투영해서 영상에 곱합니다. 측정값이 예측보다 많았던 LOR 위의 픽셀은 커지고, 적었던 LOR 위의 픽셀은 작아집니다.
- 2~4를 반복합니다.
이 과정을 수식으로 쓰면 다음과 같습니다. 이 방법이 MLEM(Maximum Likelihood Expectation Maximization) 입니다.
\[x^{(k+1)}_j = \frac{x^{(k)}_j}{\sum_i A_{ij}} \sum_i A_{ij} \frac{y_i}{\sum_{j'} A_{ij'} x^{(k)}_{j'}}\]| 기호 | 의미 |
|---|---|
| \(x_j\) | 픽셀 \(j\)의 방사능 (우리가 구하려는 영상) |
| \(y_i\) | LOR \(i\)에서 측정한 계수 |
| \(A_{ij}\) | 픽셀 \(j\)의 방사능이 LOR \(i\)에 기여하는 정도 (시스템 행렬) |
| \(\sum_j A_{ij} x_j\) | 현재 영상으로 예측한 LOR \(i\)의 계수 (순투영) |
| \(\sum_i A_{ij}(\cdot)\) | 역투영 |
| \(\sum_i A_{ij}\) | 픽셀마다 스캐너가 얼마나 잘 보는지 (감도 영상) |
MLEM은 “이 영상이 정답일 때 지금 이 측정값이 나올 확률(likelihood)“을 Poisson 분포로 쓰고, 그 확률이 최대가 되는 영상을 찾아가는 알고리즘입니다. 7편의 보정 요소들도 여기에 자연스럽게 들어갑니다. 시스템 행렬 \(A\)에 감도와 감쇠를 곱해 넣고, 예측값에 산란과 랜덤을 더하면 됩니다. 측정값 \(y\)는 건드리지 않으니 Poisson 통계가 그대로 유지됩니다.
MLEM이 PET에 잘 맞는 이유를 정리하면 이렇습니다.
- 잡음 모델이 들어 있습니다. 측정값이 Poisson 분포를 따른다는 사실을 직접 이용합니다.
- 음수가 생기지 않습니다. 양수에 양수를 곱하기만 하므로 항상 0 이상입니다.
- 물리를 그대로 넣을 수 있습니다. 감쇠, 검출기 번짐, 산란, 랜덤을 모두 시스템 모델에 넣으면 됩니다.
Python으로 써 보면
scikit-image의 radon(순투영)과 iradon(필터 없는 역투영)만 있으면 MLEM을 몇 줄로 구현할 수 있습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
import numpy as np
from skimage.transform import radon, iradon

theta = np.linspace(0., 180., 180, endpoint=False)

def A(x):   # 순투영: 영상 → sinogram
    return radon(x, theta=theta, circle=True)

def AT(y, n):  # 역투영: sinogram → 영상 (필터 없음)
    return iradon(y, theta=theta, circle=True, filter_name=None, output_size=n)

def mlem(y, n_iter, n):
    yy, xx = np.mgrid[:n, :n]
    fov = (xx - n/2 + 0.5)**2 + (yy - n/2 + 0.5)**2 < (n/2 - 1)**2
    x = fov.astype(float)                     # 1. FOV 안을 균일하게 채우고 시작
    sens = np.maximum(AT(np.ones_like(y), n), 1e-9)   # 감도 영상 A^T 1
    for _ in range(n_iter):
        y_pred = A(x)                         # 2. 예측
        ratio = y / np.maximum(y_pred, 1e-9)  # 3. 비교
        x = x * AT(ratio, n) / sens           # 4. 역투영해서 곱으로 보정
    return x
위 수식의 네 단계가 코드 네 줄에 그대로 대응합니다. 딥러닝으로 치면 파라미터 대신 영상 자체를 최적화 변수로 두고 업데이트를 반복하는 셈입니다. 다만 gradient를 더하는 대신 비율을 곱한다는 점이 다릅니다.
반복할수록 좋아지다가, 나빠진다
MLEM에는 중요한 함정이 하나 있습니다. 계수가 적은 가상 데이터로 직접 돌려 보면 바로 드러납니다.
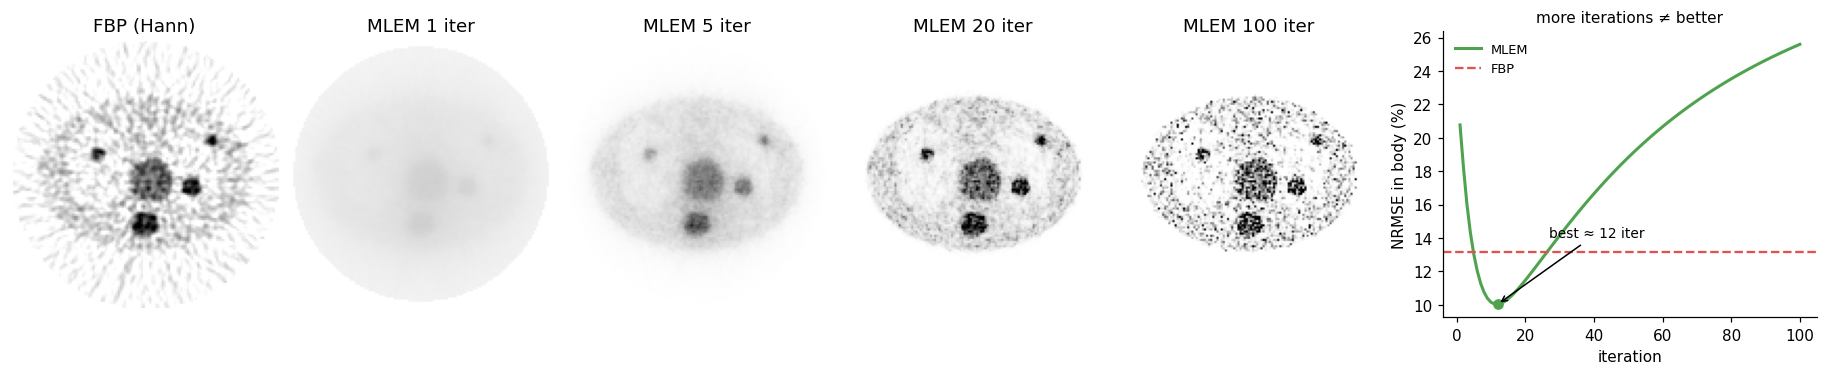 같은 저계수 데이터에서 FBP와 MLEM을 비교한 결과. MLEM은 초반에 빠르게 좋아지다가 어느 시점부터 잡음이 커지며 오히려 나빠집니다.
- 1회: 거의 균일합니다. 아직 흐릿한 윤곽뿐입니다.
- 5회: 큰 구조가 드러납니다.
- 20회: 작은 병변까지 선명해지지만 잡음이 늘기 시작합니다.
- 100회: 잡음이 영상을 뒤덮습니다.
오른쪽 그래프에서 몸 안의 오차는 약 12회에서 가장 작고(약 10%), 그 뒤로 계속 커져 100회에서는 FBP보다도 나빠집니다. 이유는 MLEM이 측정값에 점점 더 정확히 맞추려 하기 때문입니다. 그런데 측정값에는 잡음이 섞여 있으니, 끝까지 가면 잡음까지 영상으로 재현해 버립니다. 딥러닝의 과적합(overfitting) 과 똑같은 현상이고, 해결책도 비슷합니다.
- 조기 종료(early stopping): 적당한 반복 횟수에서 멈춥니다.
- 후처리 필터: 재구성이 끝난 영상에 가우시안 필터를 씌웁니다.
- 정규화(regularization): “영상은 대체로 매끄럽다” 같은 사전 지식을 목적 함수에 더합니다. 이렇게 하면 반복을 끝까지 해도 잡음이 폭발하지 않습니다. 이런 방법을 벌점 우도(penalized likelihood) 재구성이라고 하고, 최근 상용 장비에 들어가 있습니다.
최적 반복 횟수는 데이터의 계수 수준에 따라 달라집니다. 이전 글에서 해상도(즉 LOR당 계수)가 높을수록 최적 반복 횟수가 늘어나는 것을 실측했습니다. 고정값을 쓰기보다 데이터에 맞춰 정해야 합니다.
OSEM: 데이터를 나눠서 더 자주 고치기
MLEM의 단점은 느리다는 것입니다. 한 번 고칠 때마다 전체 데이터를 순투영하고 역투영해야 하는데, 수십 번 반복하려면 시간이 오래 걸립니다.
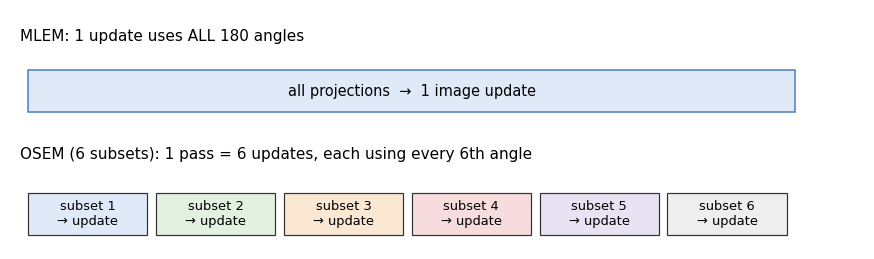 MLEM은 모든 각도를 다 본 뒤 한 번 고칩니다. OSEM은 각도를 부분집합으로 나눠, 부분집합 하나를 볼 때마다 한 번씩 고칩니다.
OSEM(Ordered Subsets EM) 은 각도를 여러 부분집합(subset) 으로 나누고, 부분집합 하나를 볼 때마다 영상을 고칩니다. 부분집합이 6개라면 데이터 전체를 한 번 훑는 동안 영상을 6번 고치는 셈이라, 거의 6배 빠르게 수렴합니다. 딥러닝의 미니배치 학습과 같은 발상입니다. 전체 데이터로 한 번 업데이트하는 것보다 작은 묶음으로 여러 번 업데이트하는 게 빠릅니다.
그래서 임상에서는 “반복 3회 × 부분집합 21개” 같은 식으로 설정합니다. 대략 “반복 횟수 × 부분집합 수”가 MLEM의 반복 횟수와 비슷한 효과를 냅니다. OSEM은 1990년대에 나온 뒤 지금까지 임상 PET의 표준 재구성 방법입니다.
재구성 모델을 더 정확하게
반복 재구성의 강점은 물리를 모델 안에 넣을 수 있다는 점입니다. 최근 장비들은 여기에 몇 가지를 더합니다.
- PSF 모델링(resolution recovery): 검출기의 번짐(4편)을 시스템 행렬에 넣어서 재구성 과정에서 번짐을 되돌립니다. 영상이 선명해지는 대신, 경계에서 값이 튀는 현상(Gibbs 아티팩트)이 생길 수 있습니다.
- TOF 정보: 두 광자의 도착 시간 차이로 LOR 위의 위치를 좁혀서 재구성에 넣습니다. 9편에서 다룹니다.
- 움직임 보정: 호흡이나 심장 박동에 따라 데이터를 나누고, 움직임을 모델에 넣습니다.
정리
- 재구성은 그림자들로부터 물체를 되찾는 역문제입니다. 잡음이 많고, 잡음이 증폭되기 쉽습니다.
- 역투영은 측정값을 직선을 따라 되돌려 칠하는 것입니다. 그것만으로는 영상이 흐려집니다.
- FBP는 고주파를 키우는 필터를 먼저 씌워 흐려짐을 상쇄합니다. 빠르지만 잡음에 약합니다.
- MLEM은 추측 → 예측 → 비교 → 보정을 반복합니다. Poisson 잡음과 물리 모델을 그대로 넣을 수 있고 음수가 생기지 않습니다.
- MLEM은 과적합합니다. 반복을 너무 많이 하면 잡음까지 재현합니다. 조기 종료, 후처리 필터, 정규화로 막습니다.
- OSEM은 데이터를 부분집합으로 나눠 더 자주 고칩니다. 미니배치와 같은 발상이고, 임상 표준입니다.
마지막 편에서는 재구성된 영상의 값을 숫자로 읽는 법(SUV), 시간 정보를 이용하는 TOF, 그리고 딥러닝이 PET을 어떻게 바꾸고 있는지 살펴봅니다.
참고문헌
- Shepp LA, Vardi Y. Maximum likelihood reconstruction for emission tomography. IEEE Trans Med Imaging. 1982;1(2):113–122. doi:10.1109/TMI.1982.4307558
- Hudson HM, Larkin RS. Accelerated image reconstruction using ordered subsets of projection data. IEEE Trans Med Imaging. 1994;13(4):601–609. doi:10.1109/42.363108
본문의 수치는 위 문헌과 대조해 확인했습니다. 그림은 모두 위 수치와 물리 식을 바탕으로 Python으로 직접 계산해 그린 것입니다.
PET 원리 시리즈