잃어버린 코드 되살리기 — SITL 재구성 네트워크를 PyTorch로 이식하기
석사 때 했던 SITL 재구성 연구의 코드를 대부분 잃어버렸습니다. 남은 건 학회 포스터 PDF 한 장, 모델 정의 파일 하나(HYG_model.py), 그리고 학습 스크립트 하나였습니다. 손실 함수와 유틸리티가 들어 있던 utils 모듈은 통째로 없었습니다.
원본은 TensorFlow였는데, 이참에 PyTorch로 다시 짜기로 했습니다. 앞선 글에서 학습 데이터 파이프라인을 복원했으니, 이번엔 모델과 학습 쪽입니다.
이 글은 그 과정에서 부딪힌 것들을 정리한 기록입니다. 잘 된 것보다 막힌 것과 그 원인이 더 많습니다.
SITL이 하는 일
먼저 무엇을 이식하는지 짧게 짚겠습니다.
Sinogram에서 영상을 복원하려면 두 도메인을 잇는 층이 필요합니다. AUTOMAP이나 DeepPET은 이걸 Fully-Connected Layer로 학습시키는데, 그 층 하나가 파라미터의 대부분을 차지합니다. DeepPET은 6,360만 개입니다.
그런데 영상의 어느 픽셀이 sinogram의 어느 위치에 대응하는지는 Radon 변환으로 이미 정해져 있습니다. r = x·cosθ + y·sinθ. 학습으로 알아낼 필요가 없습니다.
SITL(Sinogram-to-Image Transform Layer) 은 이 대응 관계를 미리 계산해 인덱스 테이블로 저장해두고, gather와 point-wise convolution만 수행합니다. 학습 파라미터는 247,250개로 줄어듭니다.
문제 1 — 중간 텐서가 8.4GB
원본 구조를 그대로 옮기면 이렇게 됩니다.
1
2
gather 결과 : (B, 512, 512, 672, 7)  →  4.9 GB / 샘플
슬라이딩 합 : (B, 512, 512, 672, 5)  →  3.5 GB / 샘플
autograd가 이걸 저장하면 A100 80GB에서도 batch 1이 빠듯합니다. 학습이 불가능합니다.
해결은 뒤따르는 1×1 convolution을 SITL 안으로 융합하는 것이었습니다. 그 conv는 결국 출력 채널 16개짜리 선형 사상입니다. 식으로 쓰면
1
y[i,j,c] = mask[i,j] · Σ_{k,o,t}  x[k, idx[i,j,k,o+t]] · w[i,j,k,t] · V[k,o,c]
출력 채널이 16개뿐이니 angular view(k)를 청크로 나눠 누적할 수 있습니다. 청크마다 gradient checkpointing을 걸면 활성값 저장량도 청크 하나 분량으로 묶입니다.
| 원본 구조 | 융합 구현 | |
|---|---|---|
| 샘플당 중간 텐서 | 8.4 GB | 약 0.1 GB |
수학적으로는 같은 연산입니다. NumPy로 원본 구조를 직역해 대조했더니 상대오차가 5.7e-7(float32 정밀도 한계)이었고, checkpointing on/off의 gradient 차이는 정확히 0이었습니다.
문제 2 — 학습이 아예 안 됨
이식을 마치고 돌렸더니 NRMSE가 45.52%에 완전히 고정됐습니다. loss는 조금씩 줄어드는데 성능이 안 변합니다.
파고들었더니 출력단 ReLU 직전 값이 전부 음수였습니다. gradient가 0이니 영원히 못 빠져나옵니다. loss가 줄어든 건 L1 정규화 항이 작아진 것뿐이었습니다.
처음엔 학습률 탓인가 했지만 낮춰도 같았습니다. 층별 활성값을 재보니 원인이 보였습니다.
1
2
입력 std 0.178  →  pre 0.027  →  SITL 0.034  →  post 0.012  →  출력 0.016
정답 std 0.316
신호가 층을 지날 때마다 감쇠해서 출력이 정답의 1/20 수준입니다. 원인은 초기화 규약 차이였습니다. Keras Conv2D의 기본값은 glorot_uniform인데 PyTorch는 kaiming_uniform(a=√5)이라 gain이 훨씬 작습니다. Keras에서 PyTorch로 옮길 때 흔한 함정입니다.
glorot으로 맞추니 죽지는 않게 됐지만, 시드에 따라 여전히 실패했습니다. 초기 몇 스텝을 계측해보니 step 2에서 loss가 0.15에서 22.9로 폭발하고 있었습니다. 출력이 정답보다 20배 작으니 첫 gradient가 과도하게 커지고, 운이 나쁘면 그대로 음수로 밀려 죽는 것이었습니다.
결국 범인은 학습률이었습니다. 제가 스모크 테스트 편의로 1e-3을 썼는데, 원본 train.py의 값은 1e-4였습니다. 원래 값으로 되돌리니 시드 8개 전부 안정적으로 수렴했습니다.
안전장치도 같이 넣었습니다.
- 출력단 편향을 학습셋 정답 평균으로 초기화 — “평균값 상수 영상”에서 출발하니 ReLU가 항상 살아 있습니다
- gradient clipping
원본 하이퍼파라미터를 임의로 바꾸지 말 것. 바꿨다면 그것부터 의심할 것. 이번 건은 이 한 줄로 정리됩니다.
문제 3 — 전처리에 7.5시간
SITL은 인덱스 테이블을 미리 만들어둬야 합니다. 512×512 영상의 픽셀 262,144개 각각에 대해 “이 점이 sinogram 어디에 기록되는지”를 계산하는 작업입니다.
원래 구현은 픽셀마다 델타 함수 영상을 만들어 skimage.radon을 호출했습니다. 64코어 서버에서 7.5시간이 걸렸습니다.
생각해보면 낭비가 큽니다. 점 하나의 위치를 알아내려고 512×512 영상 전체를 672번 회전시키고 있으니까요.
skimage의 내부를 보면 역매핑 공식이 이렇습니다.
1
2
3
src_x =  cos·c + sin·r − center·(cos+sin−1)
src_y = −sin·c + cos·r − center·(cos−sin−1)
output[r,c] = bilinear(image, src_y, src_x)
입력이 델타 함수면 src가 그 점 근방인 (r,c)만 0이 아닙니다. 그러니 그 몇 칸만 세면 됩니다.
1
2
3
4
5
c0 = cos_a * (px + ox) - sin_a * (py + oy)
r0 = sin_a * (px + ox) + cos_a * (py + oy)
for dc in (-2,-1,0,1,2):
    for dr in (-2,-1,0,1,2):
        ...  # 25칸만 평가
근사가 아니라 같은 연산을 필요한 부분만 하는 것입니다. 실제로 전체 텐서가 바이트 단위로 일치했습니다.
| skimage 호출 | 해석적 경로 | 배속 | |
|---|---|---|---|
| 256×256 / 336 view (전체) | 649.6초 | 3.2초 | 201× |
| 512×512 / 672 view (점 1개) | 607.5 ms | 0.42 ms | 1,437× |
7.5시간이 40초가 됐습니다.
GPU 두 장 쓰기
RTX A6000 두 장짜리 서버에서 DDP로 돌렸습니다. 두 가지를 조심해야 했습니다.
broadcast_buffers=False— SITL의 인덱스/가중치/마스크는 각 프로세스가 같은 파일에서 읽는 상수 테이블이라 동기화가 불필요합니다. 게다가 인덱스를int16으로 바꾼 뒤엔 NCCL이 broadcast하지도 못합니다(TypeError: ... not supported for NCCL: Short).static_graph=True— gradient checkpointing과 함께 쓰려면 필요합니다.
처음엔 GPU 사용률이 13%밖에 안 나왔습니다. 배치를 1에서 4로 늘려도 에포크 시간이 139초에서 129초로 거의 안 줄었습니다. 병목이 배치가 아니라 청크 42번 순차 처리(672뷰 ÷ 16)였던 것입니다.
48GB 중 7.7GB만 쓰고 있었으므로, 메모리를 활용하는 쪽으로 바꿨습니다.
| 설정 | 에포크 | GPU |
|---|---|---|
| chunk 16 + checkpointing | 139초 | 13% |
| chunk 112 + checkpointing 끔 | 101초 | 100% |
메모리를 아끼려고 넣은 checkpointing이 정작 메모리가 남는 상황에서는 발목을 잡고 있었습니다.
학습 결과
300 에포크를 돌렸습니다. 약 8.5시간입니다.
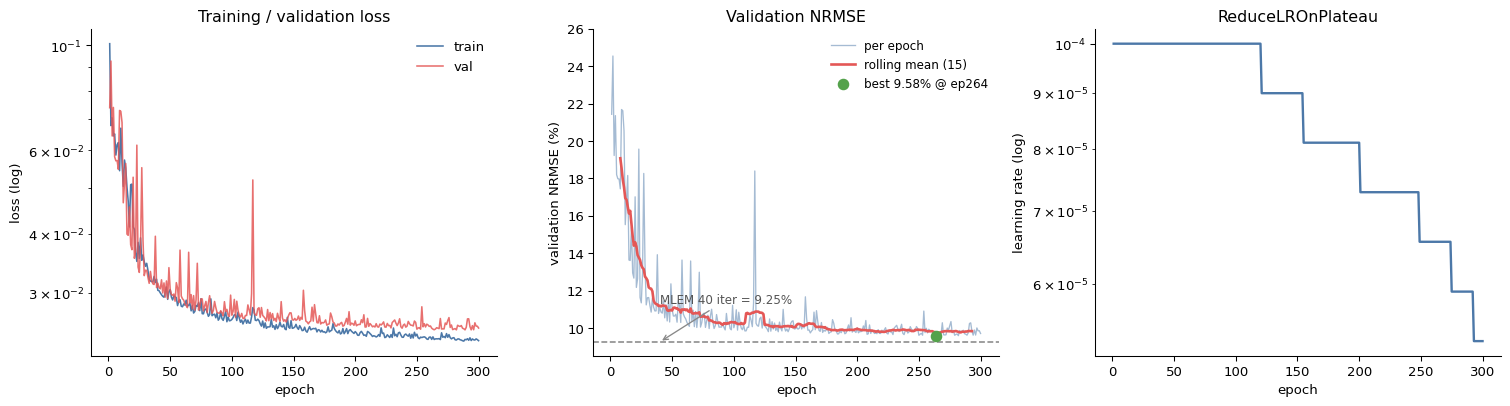 왼쪽부터 손실, 검증 NRMSE, 학습률 스케줄. 검증 NRMSE는 24.5%에서 시작해 9.58%(264 에포크)까지 내려갔습니다.
테스트셋 34장(학습·검증에 쓰이지 않음) 결과입니다.
| 방법 | NRMSE |
|---|---|
| FBP | 34.31% ± 2.81 |
| MLEM (40 iter) | 9.25% ± 2.29 |
| C3-SITL-C3 (PyTorch) | 10.52% ± 1.83 |
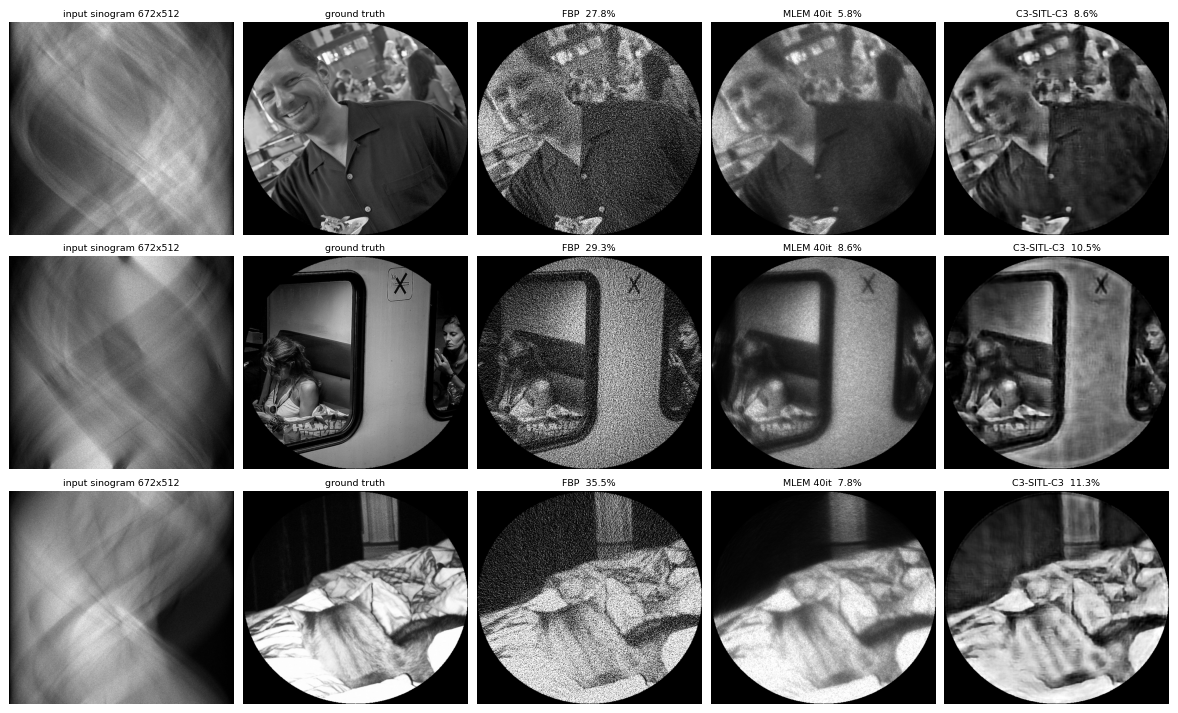 왼쪽부터 입력 sinogram, 정답, FBP, MLEM, SITL 네트워크
딥러닝이 MLEM을 못 이겼습니다
숫자만 보면 고전 방법인 MLEM(9.25%)이 학습 모델(10.52%)보다 낫습니다. 원 논문에서는 SITL이 DeepPET을 앞섰는데 말이죠.
영상을 보면 성격이 다릅니다.
- FBP — 잡음이 심합니다
- MLEM — 깨끗하지만 뭉개집니다. 이불 주름이나 인물 디테일이 뭉텅이로 사라집니다
- SITL — 디테일은 더 살아있지만 격자 아티팩트가 보입니다
NRMSE는 제곱오차라 “애매하면 흐리게” 쪽이 유리합니다. MLEM이 그 전략을 택한 셈입니다. 표준편차는 오히려 학습 모델이 ±1.83으로 MLEM의 ±2.29보다 안정적입니다.
그래도 이건 변명이고, 재현에 성공했다고 말하기는 어렵습니다.
가장 큰 원인은 데이터입니다. 원 연구는 MS COCO 전체(118,287장)로 학습했는데, 이번엔 512 crop이 가능한 val2017 343장만 썼습니다. 학습에 쓴 건 241장입니다. 약 500배 적습니다.
COCO는 대부분 640×480이라 짧은 변의 중앙값이 427px입니다. 512로 center crop하면 5,000장 중 343장만 남습니다. 해상도를 올린 대가였습니다.
격자 아티팩트도 이와 무관하지 않아 보입니다. SITL은 7개 bin에서 3-tap을 5번 슬라이딩하는 구조라 각도·radial 방향의 격자 패턴을 만들 소지가 있고, 데이터가 충분하면 post-convolution이 학습으로 이를 억제합니다. 241장으로는 부족합니다.
정리
되살린 것과 남은 것을 나눠 적어둡니다.
되살린 것
- SITL 레이어 — 원본과 수치가 일치하고(상대오차 5.7e-7), 메모리는 84배 적게 씁니다
- 파라미터 247,250개 — 포스터 표의 값과 정확히 일치합니다
- 전처리 파이프라인 — 7.5시간에서 40초로
- 멀티 GPU 학습 — 두 장 모두 100%
남은 것
- 데이터 241장. 이걸 늘리는 게 다음 순서입니다
- 손실 함수는 이름(
l2_and_gradient_and_proj_loss)에서 역설계한 것이라 원본과 계수가 다를 수 있습니다 - auxiliary loss 가중치는 전부 0.1로 임의 설정했고 튜닝하지 않았습니다
코드를 잃어버린 건 뼈아팠지만, 다시 짜면서 원본에 없던 것들(메모리 융합, 해석적 전처리)을 얻었습니다. 무엇보다 왜 그렇게 짰는지를 다시 이해하게 됐습니다. 그게 제일 큰 소득인 것 같습니다.