UMUD 챌린지 ⑦ — 3등에서 2등으로: 긴 화면에서만 PA를 당기다
⑥편 이후 이틀 동안 public LB가 0.25482 → 0.24452 → 0.23883으로 내려갔습니다. 순위는 3등에서 2등이 됐고, 1등(0.23870)과는 0.00013 차이입니다. 이번에도 점수를 움직인 건 모델이 아니라 측정 관례였습니다. 특히 두 번째 개선은 “검증 세트에는 거의 없는데 테스트에는 많은 영상”을 찾아낸 덕분이었습니다.
대회 진행 중이라 코드와 대회 이미지는 싣지 않습니다. 그림은 모두 직접 그린 도식과 수치 차트입니다. ‘실측’은 한 가지만 바꾼 제출로 확인한 값이고, 나머지는 ‘추정’입니다.
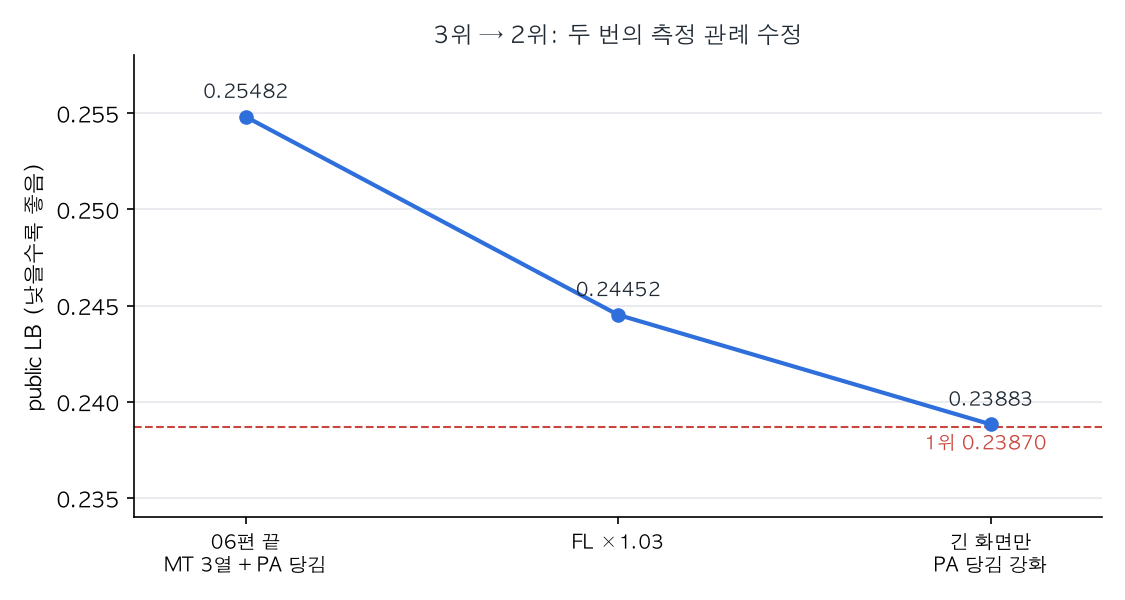 ⑥편 이후 바꾼 것은 두 가지뿐이다
1. FL에 1.03을 곱한다
FL(근섬유다발 길이)은 점수의 절반을 차지합니다. 다발이 화면보다 길면 평가자는 다발을 직선으로 연장해 근막과 만나는 점까지 잽니다. 문헌을 보면 이렇게 손으로 연장한 길이는 화면이 좁을수록 4~13% 길게 나옵니다. 우리 측정은 평가자보다 조금 짧게 재고 있을 가능성이 있었습니다.
그래서 모든 영상의 FL에 같은 배율을 곱하는 탐침을 미리 정한 네 점만 제출했습니다.
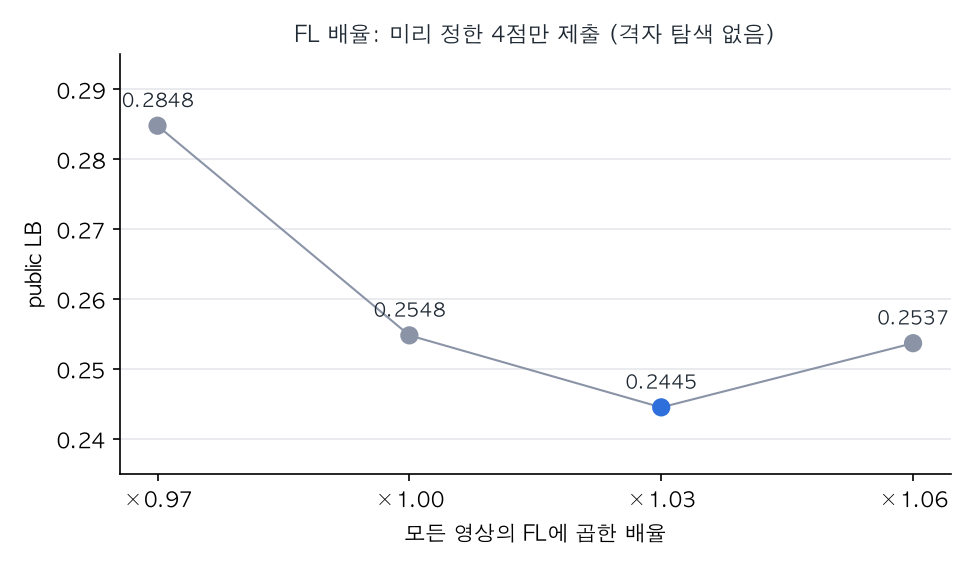 ×1.03에서 가장 낮고 양옆으로 올라간다. 배율을 더 잘게 나눠 찔러 보지는 않았다
×1.03이 0.24452로 가장 좋았습니다. 그 뒤로 배율을 0.01 단위로 더 쪼개 찾는 일은 하지 않았습니다. public은 약 102장이라 그렇게 맞추면 private 207장에서 손해를 볼 수 있습니다.
2. 모델 쪽 변경은 이번에도 전부 탈락
같은 기간에 모델 쪽 실험을 여섯 가지 했습니다.
| 실험 | 결과 |
|---|---|
| 기존 학습 실행 40개의 다발 출력 재평가 | 2 SE를 넘는 개선 없음 |
| 학습 데이터 검증 영상으로 다발 PA 대리 점수 만들기 | 벤치와 순위 상관 −0.22, 쓸 수 없음 |
| 다발 연결성 손실(clDice) 가중 두 배 | 두 짝 모두 다발 PA 악화 |
| 다발 배경 픽셀 가중 0.5 → 1.0 | 두 짝 모두 벤치 PA 악화 |
| 다발 방향을 각도 구간 분류로 학습 | 불통과 |
| 테스트 묶음별 BN 통계 재추정(AdaBN) | NeuAge 악화 |
모든 비교는 같은 증강 난수를 쓴 짝끼리 했습니다. 같은 설정이라도 난수만 바꾸면 점수가 0.01 넘게 흔들려서, 짝 없이 비교하면 운을 실력으로 착각하기 쉽습니다.
3. “로컬에서 더 줄일 오차가 없다”
막힌 이유를 찾으려고 남은 오차를 다시 쪼갰습니다. 전문가 벤치마크에는 평가자가 여러 명 있습니다. 그래서 평가자 두 명이 서로 얼마나 다르게 재는지를 같은 점수 식으로 계산할 수 있습니다. 이 값이 사실상의 바닥입니다.
| 평가자 2명 사이 (바닥) | 우리 예측 | |
|---|---|---|
| 벤치35 | 0.200 | 0.191 |
| 학습과 겹치지 않는 10장 | 0.225 | 0.201 |
우리 PA·FL은 이미 평가자끼리의 차이보다 작습니다. 벤치를 기기, 외삽 비율, 조각 수 등 어떤 조건으로 나눠 봐도 바닥을 넘는 FL 오차가 없었습니다. 그런데 테스트 점수는 0.24입니다. 그렇다면 남은 차이는 테스트에만 있는 영상에서 나와야 합니다.
4. 테스트에만 있는 영상: R < 0.95
다발이 두 근막 사이를 직선으로 가로지른다면 세 값 사이에 간단한 관계가 있습니다.
\[R = \frac{\mathrm{FL}\,\sin \mathrm{PA}}{\mathrm{MT}} \approx 1.07\]근막이 완전히 평행하지 않아 1보다 조금 큽니다. 우리 예측에서 R을 계산하면 대부분 1 근처인데, 0.95보다 작은 영상이 있습니다. 세 값이 서로 맞지 않는다는 뜻입니다. FL이 짧거나, MT가 길거나, PA가 낮거나 셋 중 하나입니다.
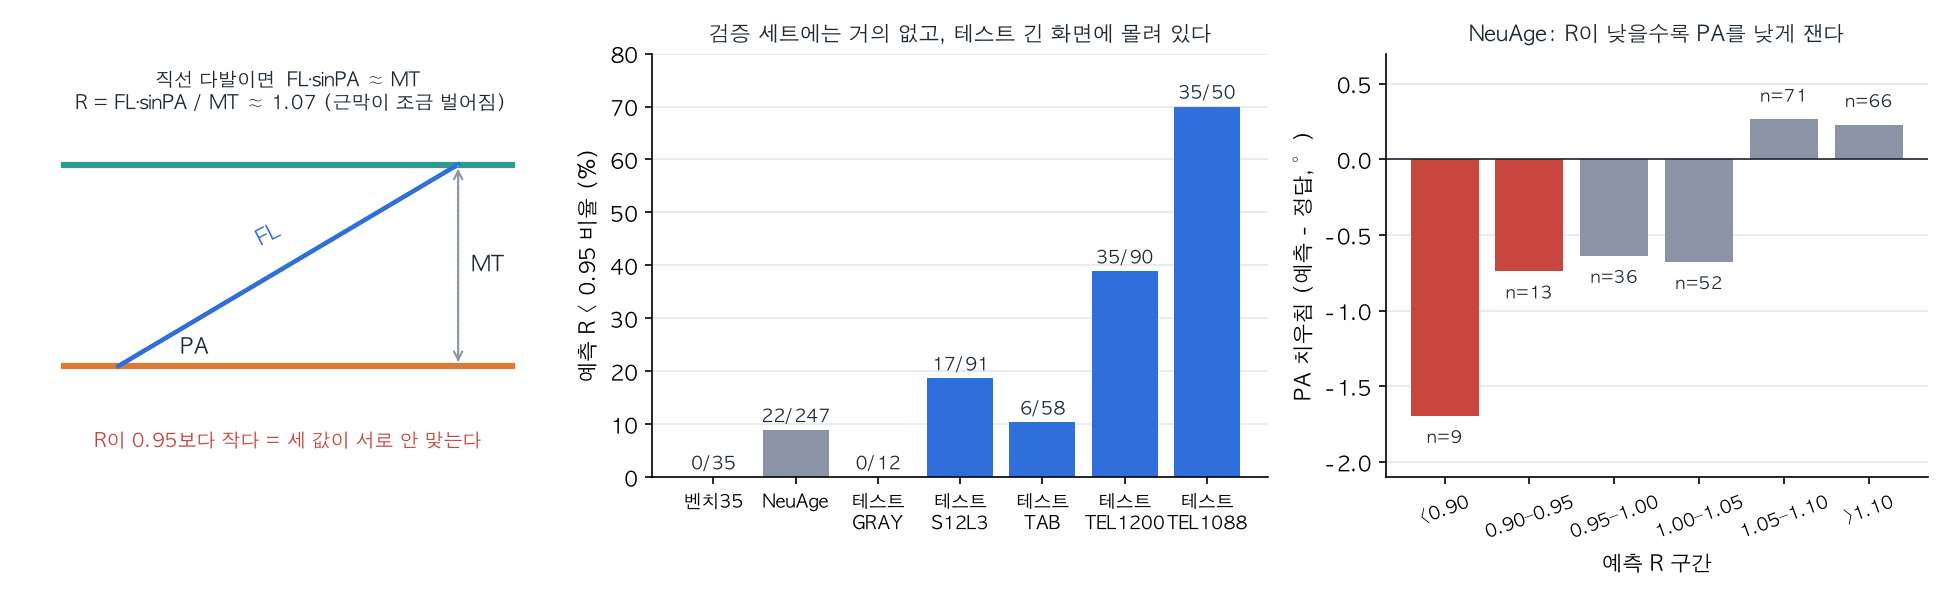 왼쪽: R의 의미. 가운데: R<0.95인 영상의 비율. 오른쪽: NeuAge에서 R 구간별 PA 치우침
가운데 그림이 핵심입니다. 이런 영상은 벤치에 0장, NeuAge에 22장(9%)뿐입니다. 그런데 테스트에는 94장이 있고, 특히 다발이 화면보다 1.5배 이상 긴 TEL 기기 화면에 몰려 있습니다(TEL1088 70%, TEL1200 39%). 로컬 검증으로는 이 영상들을 거의 볼 수 없었던 셈입니다.
오른쪽 그림은 정답이 있는 NeuAge에서 이런 영상의 PA를 본 것입니다. R이 0.90보다 낮으면 PA를 평균 1.7°, 0.90~0.95면 0.74° 낮게 잽니다. 세 값 중 범인은 PA였습니다.
5. 낮은 R에서만 PA를 더 당긴다
⑥편의 PA 당김은 모든 영상에 같은 세기(λ = 0.2)를 썼습니다.
\[\sin \mathrm{PA}' = \sin \mathrm{PA}\cdot r^{-\lambda},\qquad r = \frac{\mathrm{FL}\,\sin \mathrm{PA}}{1.07\,\mathrm{MT}}\]이번에는 λ를 R에 따라 바꿨습니다. R이 0.95 이상이면 그대로 0.2이고, 0.95에서 0.90으로 내려가는 동안 0.5까지 올립니다. NeuAge에서 R 구간별로 PA 오차가 가장 작아지는 λ가 정확히 이 모양이었습니다(R<0.90에서 0.5, 정상 R에서 0~0.2).
| 값 | |
|---|---|
| 테스트에서 바뀐 영상 | 94장 (나머지 215장은 그대로) |
| PA 변화 | 평균 +0.37°, 최대 +1.06° |
| FL·MT | 바꾸지 않음 |
| 로컬 변화 | 벤치 1장·NeuAge 22장만 바뀜, Δ −0.0002 (사실상 0) |
| public LB | 0.24452 → 0.23883 (−0.00569) |
로컬에서는 거의 아무것도 바뀌지 않았지만 LB는 크게 움직였습니다. 바뀌는 영상이 테스트에만 있으니 당연한 결과입니다. 제출 전에 “이 규칙이 완벽하게 맞으면 최대 0.0062까지 좋아진다”고 계산해 두었는데, 실제로 그 약 90%를 얻었습니다.
제출 전에 잡은 실수
처음 만든 파일에서는 94장이 아니라 180장이 바뀌었습니다. 연구 단계의 R은 1.07로 나누기 전 값이었고, 코드 안의 r은 나눈 뒤의 값이었습니다. 문턱을 1.07로 나눠 고치자 정확히 94장, 최대 +1.06°가 나왔습니다. “바뀌는 영상 수와 최대 변화량”을 제출 전 확인 항목으로 적어 두지 않았다면 다른 규칙을 시험하고 엉뚱한 결론을 냈을 겁니다.
왜 예전에는 실패했나
10/6에 “PA를 전체적으로 더 올리는” 시도는 기각됐습니다. 이번 결과를 보면 이유가 보입니다. 정상 R 영상까지 함께 올리면, 낮은 R 영상에서 얻는 이득을 정상 영상의 손해가 깎아 먹습니다. 어디를 올릴지가 얼마나 올릴지보다 중요했습니다.
6. 같은 날 버린 것들
| 시도 | 결과 | 판정 |
|---|---|---|
| FL 배율을 PA에 따라 기울이기 (PA 낮을수록 더 길게) | LB +0.0027 | 기각 |
| 단독 영상 측정 TTA (문턱·영역 이동·반전 6회 중앙값) | 흔들림 3.5% 감소 (기준 15%) | 기각 |
| FL에 쓰는 다발 수 3 → 4·5·6·8개 | 길이 수준을 맞추면 차이가 SE 안 | 3개 유지 |
| 측정에 실패한 모델 값을 빼고 나머지 3개 중앙값 | NeuAge +0.065 | 기각 |
두 가지가 흥미로웠습니다.
측정 TTA가 안 되는 이유. 테스트에는 같은 부위를 다섯 장씩 연속으로 찍은 묶음이 있습니다. 여기서 장마다 측정값이 FL 2~2.7mm씩 흔들립니다. 반면 측정을 흔들어(문턱, 영역 이동) 생기는 차이는 0.2~0.9mm뿐이었습니다. 흔들림은 측정이 아니라 영상 자체에서 나오므로, 측정 쪽을 흔들어서는 줄일 수 없습니다. 이 다섯 장 묶음은 정답 없이 “규칙이 얼마나 안정적인가”를 재는 도구로도 썼습니다. 그 결과 지금의 FL 규칙(다발 3개 중앙값)이 가장 안정적이었습니다.
실패한 모델을 빼면 오히려 나빠지는 이유. 한 모델이 근막을 못 찾는 영상은 대개 다른 모델도 틀리기 쉬운 어려운 영상입니다. 실패한 칸을 “그 기기의 평범한 값”으로 채우면, 이 값이 중앙값을 극단에서 끌어내리는 안전장치 역할을 합니다.
7. 사람 눈으로 본 14장
자동으로 가장 의심스러운 학습 영상 14장을 골라 직접 검수했습니다.
- 근막 라벨이 의심된 4장 중 3장은 실제로 라벨이 틀렸습니다. 이미 학습에서 빼 둔 영상이라 판단이 맞았습니다.
- 다발 기울기가 크게 어긋난 6장 중 4장은 근섬유가 거의 보이지 않는 영상이었습니다.
- 위쪽 근막이 없어 측정이 실패한 영상도 있었습니다. 테스트에서 이런 경우는 6장이고, 모두 네 모델 중 하나만 실패했습니다.
결론은 “분할은 잘 되어 있다”였습니다. 라벨을 고쳐 다시 학습하는 작업은 하지 않기로 했습니다.
8. 다음
- 1등과 0.00013 차이입니다. public 102장으로는 잡음 범위 안이라, 지금 순위는 사실상 공동 1등에 가깝다고 봅니다. 최종 순위는 private 207장이 정합니다.
- 이번 교훈은 “검증 세트에 없는 영상을 찾아라”입니다. 다음은 같은 저 R 영상에서 FL·MT에도 비슷한 치우침이 남아 있는지 보는 것입니다.
- 미리 정한 LB 판정은 10회 중 5회를 썼습니다. 남은 기회는 아끼고, 마감 전에 성격이 다른 최종 후보 두 개를 고정할 계획입니다.