UMUD 챌린지 ⑧ — public 1등, 그리고 로컬 검증이 볼 수 없는 것
⑦편을 쓴 지 반나절 만에 public LB 1등(0.23776)이 됐습니다. 2등은 0.23820이라 차이가 0.00044뿐입니다. public은 약 102장이라 이 정도 차이는 잡음 안이고, 최종 순위는 마감 뒤 private 207장으로 정해집니다. 이 글은 오늘 오후에 한 실험들과, 그 과정에서 분명해진 로컬 검증의 한계를 정리합니다.
대회 진행 중이라 코드와 대회 이미지는 싣지 않습니다. 그림은 모두 직접 만든 수치 차트입니다. ‘실측’은 한 가지만 바꾼 제출로 확인한 값이고, 나머지는 ‘추정’입니다.
1. 1등이 된 한 걸음과 실패한 한 걸음
⑦편의 핵심은 R = FL·sin(PA)/MT가 0.95보다 작은 영상, 즉 세 값이 서로 맞지 않는 영상에서만 PA를 더 세게 당기는 규칙이었습니다. 이번에는 같은 방향의 질문을 두 개 더 했습니다.
| 시도 | 바뀐 영상 | public | 판정 |
|---|---|---|---|
| 기준(⑦편) | — | 0.23883 | — |
| R 문턱을 0.95 → 1.00으로 넓힘 | 140장, 새로 들어간 47장은 평균 +0.14° | 0.23776 | 미리 정한 문턱(−0.0019) 안쪽 → 최종 B안 후보 |
| 좁은 화면(TAB 58장)만 FL을 3% 더 늘림 | 58장, 평균 +2.1mm | 0.24006 | 폐기 |
첫 번째는 좋아졌지만, 제출 전에 적어 둔 채택 기준에는 조금 못 미쳤습니다. 그래서 기준 파이프라인은 바꾸지 않고 최종 2개 중 하나의 후보로만 남겼습니다. 리더보드에는 가장 좋은 제출이 자동으로 표시되기 때문에, 순위는 이 0.23776으로 계산됩니다.
두 번째는 “좁은 화면에서 손으로 연장한 다발이 더 길게 나온다”는 문헌을 근거로 했습니다. 하지만 FL을 더 늘리는 시도는 오전의 ‘PA에 따라 FL 기울이기’에 이어 두 번째 실패입니다. 테스트 평가자의 FL 관례에는 전체 ×1.03이 이미 맞는 수준으로 보입니다.
2. 왜 어떤 규칙은 거의 다 맞고, 어떤 규칙은 조금만 맞나
제출할 때마다 “이 규칙이 완벽하게 맞으면 점수가 최대 얼마나 좋아지나”를 계산해 두었습니다. 그 최대치 가운데 실제로 얻은 비율을 실현율이라고 부르겠습니다.
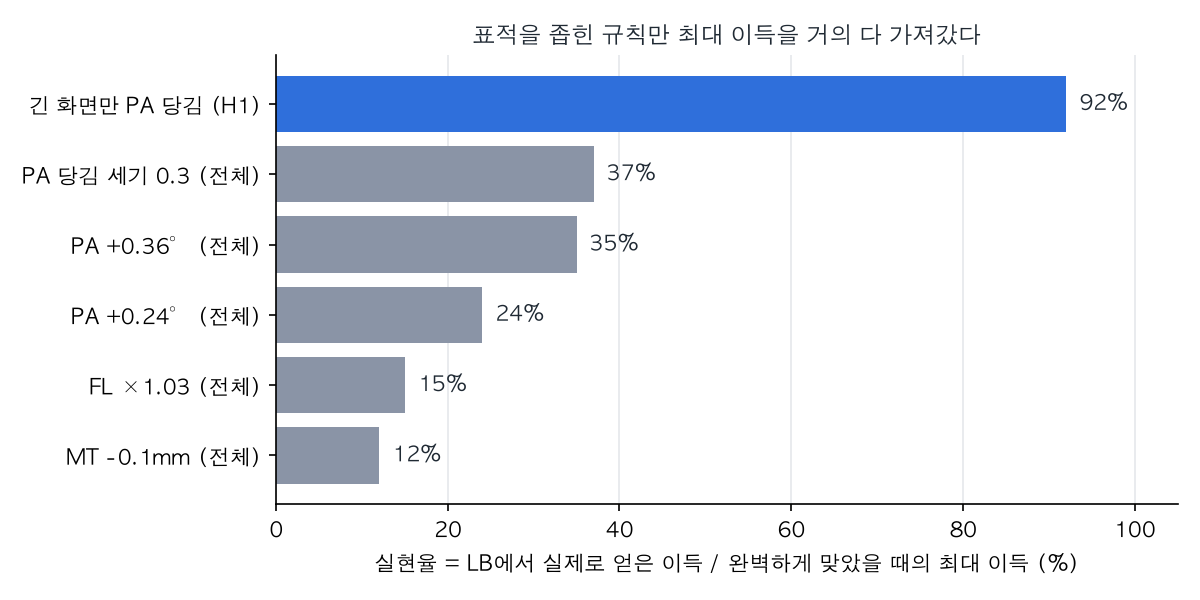 모든 영상에 똑같이 적용한 규칙은 최대 이득의 12~37%만 얻었다
차이가 뚜렷합니다.
- 모든 영상에 똑같이 적용한 규칙(PA를 일정하게 올리기, FL 배율, MT 보정)은 최대 이득의 12~37%만 얻었습니다. 맞는 영상에서 얻는 만큼을 틀린 영상에서 잃기 때문입니다.
- 문제 있는 영상만 골라 고친 규칙은 92%를 얻었습니다.
다음 개선도 “어디를 고칠지”를 먼저 찾아야 한다는 뜻입니다.
3. 테스트 화면이 어둡고 매끈하다면?
두 번째 리서치에서 눈에 띄는 차이가 하나 더 나왔습니다. 테스트의 긴 화면(TEL 기기) 영상은 로컬 검증 영상보다 훨씬 어둡고 매끈합니다.
| 평균 밝기 | 선명도 (라플라시안 분산) | |
|---|---|---|
| 테스트 TEL1088 | 약 40 | 110~330 |
| 전문가 벤치마크 | 43~107 | 약 620 |
| NeuAge | 43~107 | 약 3,500 |
신경망이 학습 때 못 본 입력이라 걱정됐습니다. 그래서 로컬 영상을 테스트처럼 어둡고 흐리게 바꾼 사본을 만들었습니다. 정답은 그대로 두고, 모델 4개를 다시 돌렸습니다.
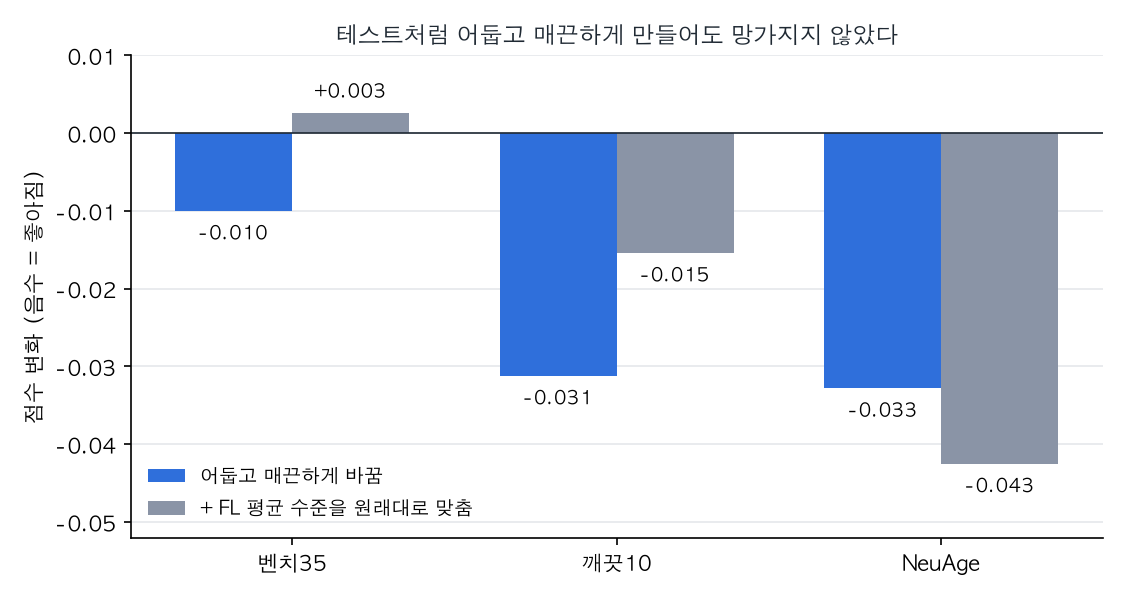 점수가 나빠지기는커녕 좋아졌다. 회색 막대는 FL 길이 수준 변화를 빼고 본 값이다
결과는 반대였습니다. 세 세트 모두 점수가 좋아졌습니다. 원인을 쪼개 보니 두 가지였습니다.
- 매끈한 영상에서는 FL이 2.5~4.5mm 짧게 나옵니다. 벤치에서는 원래 FL을 너무 길게 재고 있었는데, 이게 상쇄됐습니다. 테스트에서 FL ×1.03이 통했던 이유도 여기서 설명됩니다(추정). 테스트가 매끈해서 우리가 FL을 짧게 재고 있었던 것입니다.
- NeuAge는 지나치게 선명해서 흐리게 하면 오히려 좋아집니다. FL 수준 변화를 빼도 −0.043이 남았습니다.
결론은 “입력을 밝게 보정할 필요 없음”입니다. 이 실험은 거기서 멈췄습니다.
4. 그럼 매끈한 사본을 검증 세트로 쓰면 되지 않을까
자연스러운 다음 질문입니다. 매끈한 사본이 테스트를 더 닮았으니, 이걸로 판정하면 LB를 더 잘 맞히지 않을까요?
방법은 간단했습니다. LB 결과를 이미 아는 규칙 8개를 두 검증 세트에서 다시 재고, LB와 방향이 같은지 셌습니다. 기준은 계산 전에 적어 두었습니다. “매끈한 세트의 일치 수가 더 많을 때만 채택”입니다.
| LB와 방향 일치 (24개 중) | |
|---|---|
| 원래의 선명한 검증 세트 | 15 |
| 매끈하게 바꾼 검증 세트 | 13 |
나아지지 않았습니다. FL 배율의 최적점도 두 세트 모두 LB(×1.03)와 달랐습니다. 선명한 벤치는 ×1.00, 매끈한 NeuAge는 ×1.06이었습니다. FL의 수준은 화질보다 평가자의 측정 습관이 정한다는 쪽으로 보입니다.
더 중요한 발견이 있습니다. 1등을 만든 규칙(긴 화면 PA 당김)은 LB에서 −0.0057이었는데, 로컬에서는 어느 세트에서도 ±0.001 안이었습니다. 해당 영상이 로컬에 거의 없기 때문입니다. 테스트에만 있는 영상을 겨냥한 규칙은 로컬 검증으로 원리상 판별할 수 없습니다. 이런 규칙은 미리 정한 기준으로 LB에서 한 번씩만 확인할 수밖에 없습니다. 그 기회도 이제 3번 남았습니다.
5. 1등을 지키는 일: 재현성
이 대회의 상위 3팀은 공개 저장소에서 주최측이 결과를 다시 만들어 낼 수 있어야 상금을 받습니다. 그래서 오늘 재현성을 점검했습니다.
- 명령 한 줄로 재현: 원본 테스트 영상에서 최종 CSV까지의 모든 단계를 저장소 스크립트 하나로 묶었습니다. 실행하면 1등 제출 파일이 바이트 단위까지 똑같이 다시 만들어집니다.
- 임시 폴더 단계 정리: 실험 중에는 임시 폴더에만 있던 측정 단계가 있었습니다. 이것을 저장소로 옮겼습니다.
- 가중치 백업: 서버에만 사본이 하나 있던 모델 가중치는 로컬로 백업했습니다.
- 남은 한계: 모델을 처음부터 다시 학습하면 GPU 연산의 무작위성 때문에 가중치가 비트 단위로 같아지지는 않습니다. 그래서 학습된 가중치를 함께 넘기는 방식을 문서에 적었습니다.
함께 방법론 포스터 초안(영문·한글)도 만들었습니다. 배경지식 없이도 읽히도록 “평가자처럼 잰다”는 한 문장을 중심으로 정리했습니다.
6. 다음
- 최종 제출 2개는 서로 성격이 다른 것으로 고릅니다.
- A안: 검증된 기준
- B안: 긴 화면 PA 당김을 한 단계 더 넓힌 판으로, 우리가 찾은 테스트 특성 쪽에 거는 보험입니다.
- 남은 LB 판정 3회는 “테스트에만 있는 다른 영상 유형”을 찾았을 때만 씁니다. 지금 그런 영상을 찾는 세 번째 리서치를 돌리고 있습니다.
- public 순위는 잡음 범위 안의 1등입니다. 마감까지 이 차이가 의미 있는지는 private이 말해 줄 겁니다.