UMUD 챌린지 ⑫ — 0.02의 벽: 오차 예산과 하루에 닫은 다섯 갈래
⑪편은 “판정 도구 하나도 믿으면 안 된다”로 끝났습니다. 그 뒤 사흘(10/25~10/27) 동안 리더보드가 크게 바뀌었습니다. 상위 두 팀이 하루 사이에 0.018~0.022씩 점수를 줄였고, 우리는 public 최고점 0.20989 그대로 9위가 됐습니다. 1위와의 차이는 0.027입니다. 이번 글은 이 격차를 어디서 메울 수 있는지 따진 기록입니다. 먼저 지금 쓰는 상수가 public에 과적합됐는지 쟀습니다. 다음으로 점수를 지표별로 나눠 오차가 어디에 몰려 있는지 봤습니다. 그리고 하루 동안 다섯 갈래를 시험해 모두 닫았습니다.
대회 진행 중이라 코드와 대회 이미지는 싣지 않습니다. 그림은 모두 제출 기록과 판정 기록의 숫자로 직접 그린 차트입니다. “추정”이라고 적은 것은 실측이 아니라 해석입니다.
1. public 상수는 과적합됐나: 축소 곡선
지금 public 최고판(tel12fl85)에는 리더보드를 보며 정한 보정 상수가 네 묶음 들어 있습니다. 셀 이동, PA 당김, 화면별 보정, TEL1200 화면의 FL 수축입니다. 이런 상수는 public 102장에는 맞지만 private 207장에서는 손해일 수 있습니다. 그래서 그 크기를 직접 재 봤습니다.
방법은 간단합니다. 네 묶음을 한꺼번에 α배로 줄인 판을 냅니다. α=0이면 보정이 없는 판이고, α=1이면 지금 최고판입니다. α를 0, 0.25, 0.5, 0.75, 1로 바꿔 public 점수 곡선을 그리고 2차식으로 맞춥니다. 최저점 α*가 1보다 작으면 상수가 public 최적을 지나친 것이고, 1 근처나 그 위면 지나치지 않은 것입니다.
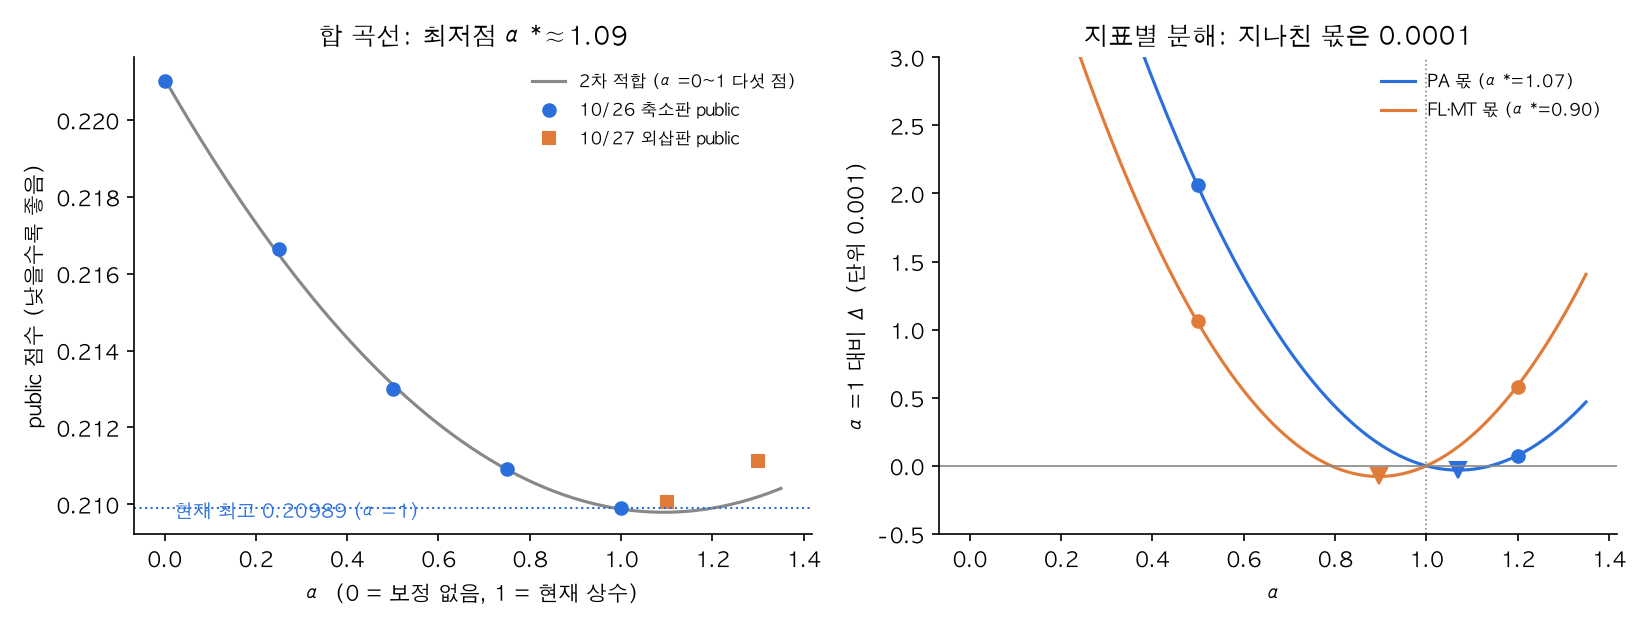 왼쪽은 네 묶음을 함께 줄인 합 곡선, 오른쪽은 PA 열과 FL·MT 열을 따로 줄여 지표별로 나눈 곡선이다. 오른쪽의 역삼각형이 지표별 최저점이다
10/26에 낸 다섯 점은 2차식에 잘 맞았습니다(최대 잔차 0.00014). 최저점은 α* = 1.09였습니다. 상수가 public 최적을 지나치지 않았고, 이득이 상수 끝까지 고르게 쌓였다는 뜻입니다.
10/27에는 한 걸음 더 갔습니다. PA 열과 FL·MT 열을 따로 줄이거나 늘린 판을 섞어 내서 두 지표의 곡선을 따로 식별했습니다. 판정식은 결과를 보기 전에 고정해 두었습니다.
| 지표 | 곡률 a | 기울기 b | 최저점 α* |
|---|---|---|---|
| PA | +0.0064 | −0.0137 | 1.07 |
| FL·MT | +0.0072 | −0.0129 | 0.90 |
FL·MT 쪽 최저점이 1보다 조금 작습니다. FL 상수가 public 최적을 약간 지나쳤다는 뜻입니다. 하지만 지나친 몫을 곡선으로 계산하면 약 0.0001입니다. 두 지표를 각자 최저점으로 옮긴 판의 예측 이득도 0.0001이었습니다. 사전에 정한 문턱(0.0003)에 못 미쳐 이 축은 닫았습니다. α를 1.1, 1.3으로 늘린 외삽판도 public이 모두 나빠졌습니다.
이 측정에서 얻은 결론은 두 가지입니다.
- 지금 상수의 private 위험은 작습니다. 과적합 몫이 0.0001이라 최종 판을 고를 때 따로 벌점을 줄 필요가 거의 없습니다. 승자의 저주 벌점도 곡선에서 다시 추정해 이전 값의 절반(방향당 약 0.0012)으로 줄였습니다.
- 상수를 더 다듬어서는 격차를 못 줄입니다. 곡선의 바닥이 지금 점수와 0.0001 차이입니다. 1위와의 0.027은 이 축에서 나올 수 없습니다.
2. 오차 예산: 어디가 틀리나
점수는 PA, FL, MT 세 지표의 정규화 오차 합입니다. 그래서 각 지표가 점수의 몇 %를 차지하는지 나눌 수 있습니다. 로컬 평가 세트 세 개와 public 추정치를 같은 방식으로 나눴습니다.
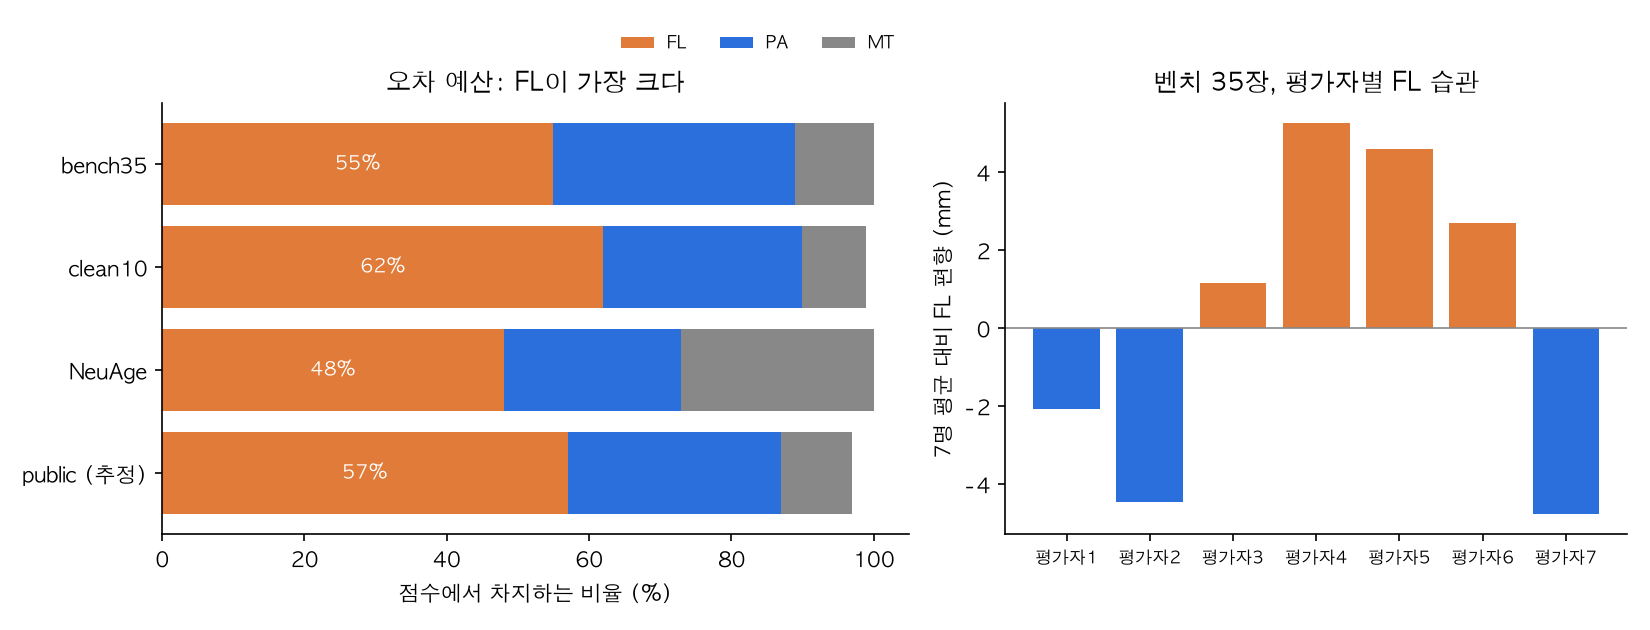 왼쪽은 지표별 오차 몫, 오른쪽은 공개 벤치마크 35장을 잰 평가자 7명 각자의 FL 편향(7명 평균 기준)이다
| 세트 | PA | FL | MT |
|---|---|---|---|
| bench35 | 34% | 55% | 11% |
| clean10 | 28% | 62% | 9% |
| NeuAge | 25% | 48% | 27% |
| public (추정) | ~30% | ~57% | ~10% |
어느 세트에서나 FL이 가장 큽니다. 1위와의 격차를 한 지표만으로 메운다고 하면, FL은 MAE를 0.8mm(FL 몫의 약 19%) 줄여야 하고 PA는 0.4°(PA 몫의 약 35%)를 줄여야 합니다. MT로는 아예 불가능합니다.
그래서 FL을 더 파고들었습니다. 공개 벤치마크 35장에는 같은 영상을 평가자 7명이 각자 잰 값이 있습니다. 대회 정답은 평가자 2명의 평균이라고 알려져 있습니다. 그렇다면 “7명 평균”을 완벽한 예측으로 보고, 그 값이 “임의의 2명 평균”과 얼마나 다른지 재면 아무리 잘 맞춰도 남는 오차의 바닥을 알 수 있습니다.
- 평가자별 FL 편향은 −4.8~+5.3mm입니다. 같은 영상에서 평가자 4는 늘 길게, 평가자 7은 늘 짧게 잽니다.
- 7명 평균으로 2명 평균을 맞춰도 FL MAE가 2.85mm 남습니다(가능한 21쌍의 평균). 우리 MAE는 4.22mm입니다.
- 즉 우리 FL 오차의 약 2/3는 “어느 2명이 쟀느냐”로 정해지는 바닥입니다. 모델을 더 좋게 해서 줄일 수 있는 몫은 나머지 1/3입니다.
- 바닥과 우리 잔차는 모두 다발이 화면 밖으로 나가 길이를 외삽해야 하는 영상에 몰립니다(외삽 영상 바닥 3.62mm, 비외삽 2.13mm). 테스트 영상은 거의 전부 외삽 영상입니다.
이 숫자로 보면 FL에서 큰 폭을 얻는 길은 두 가지뿐입니다. 하나는 public을 잰 평가자의 습관을 맞히는 것이고, 다른 하나는 외삽 방식 자체를 바꾸는 것입니다. 앞의 것은 학습 데이터에 평가자 정보가 없어 배울 수 없습니다(3절). 뒤의 것은 이번 사흘 동안 두 번 시도해서 두 번 다 실패했습니다.
3. 하루에 닫은 다섯 갈래
격차가 상수 다듬기로는 안 된다는 것이 분명해졌으니 구조를 바꾸는 쪽을 시험했습니다. 모든 후보는 판정 기준을 계산 전에 적어 두고, ⑨편의 관문(public 영상별 오차 모형)을 거쳤습니다. ⑪편에서 본 대로 관문은 낙관적이라, 관문에서 나빠지는 후보는 public에서도 나빠진다고 보고 제출하지 않았습니다.
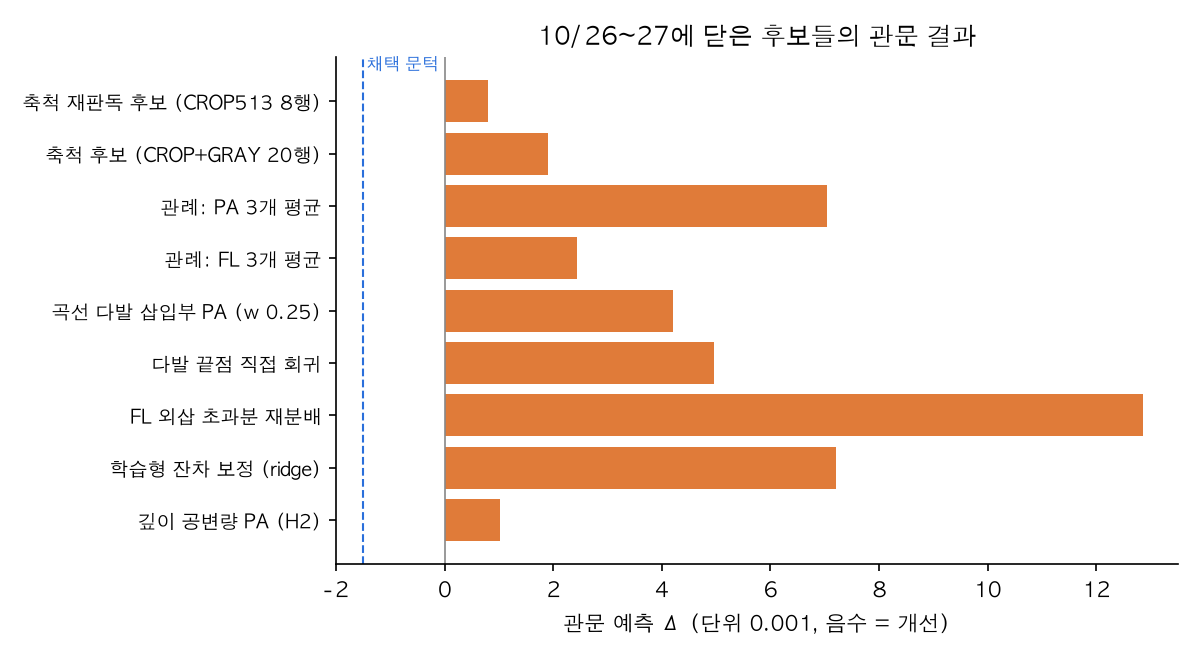 10/26~27에 시험한 후보들의 관문 Δ. 오른쪽(양수)일수록 나빠진다는 예측이다. 채택하려면 점선 왼쪽에 와야 했는데 모두 0보다 오른쪽이었다
(1) 축척 감사
상위 팀의 급등이 축척 차이에서 왔을 수 있다고 보고, 화면 종류 6가지의 px/cm를 기존 파이프라인과 별개로 다시 판독했습니다. 화면 가장자리의 눈금 간격을 직접 맞춘 결과, 판독할 수 있었던 5종 모두 기존 값과 0.12% 안에서 같았습니다. 새로 고칠 축척 오류는 없었습니다.
한 가지 흥미로운 연결은 찾았습니다. 주최측이 공개한 외부 영상 벤치마크는 FL을 7.55 px/mm로 환산했는데, 화면 눈금으로 재면 7.76이 맞습니다. 그 화면이 테스트의 한 화면 종류(8장)와 같은 장비·같은 설정이었습니다. 테스트 정답도 같은 방식으로 환산했다면 그 8장의 정답이 2.8% 길 수 있습니다. 그러나 걸리는 행이 8~20개뿐이라 기대 이득이 0 근처이고 public으로도 구분하기 어렵습니다. 기록만 하고 넣지 않았습니다.
(2) 측정 관례 대조
주최측이 토론과 공식 저장소에 적은 측정 관례를 항목별로 우리 파이프라인과 맞춰 봤습니다. PA 기준선, PA 위치, FL 선 긋기, FL 다발 선택, MT 위치, 축척 모두 일치했습니다. 어긋난 곳은 하나였습니다. 평가자는 3개를 평균하는데, 우리는 중앙값을 씁니다.
평균으로 바꾼 PA판과 FL판을 만들었더니 관문에서 둘 다 0/24로 나빠졌습니다(+0.0070, +0.0024). 평가자의 “3개 평균”은 사람이 고른 좋은 다발 3개의 평균이라, 우리가 자동으로 찾은 조각 전체의 평균과는 다른 통계량입니다. 고르는 과정이 이미 극단값을 걸러 냅니다(추정). 외부 벤치마크의 PA 정답이 10~12° 바뀐 개정도 따져 봤는데, 그 개정은 수평 기준에서 근막 기준으로 고쳐진 것이고 오히려 우리 관례 쪽으로 온 것이었습니다.
(3) 곡선 다발 PA
다발이 근막에 들어가는 끝이 휘어 있다면, 직선으로 맞춘 각도보다 끝점의 접선각이 평가자 값에 가까울 수 있습니다. 다발 조각마다 2차 곡선을 맞추고 심층 근막 쪽 끝의 접선각을 쟀습니다. 방향은 가설과 같았지만 설명력이 약했습니다(상관 −0.18~−0.45, 설명 분산 6% 이하). 섞는 비율을 가장 약하게 해도 관문이 +0.0042로 나빠져 닫았습니다.
(4) 다발 끝점 직접 회귀
FL 오차의 주범이 외삽이라면 외삽 단계를 없애면 됩니다. 다발 화소마다 그 다발의 근막-근막 양 끝점을 직접 회귀하는 모델을 따로 학습했습니다(시드 3개). 결과는 FL이 크게 짧게 나왔습니다. 화면 밖으로 나가는 긴 다발일수록 모델이 길이를 줄였습니다. 긴 화면에서는 −28mm였습니다. 다섯 번째 FL 입력으로 넣어도 관문 +0.0050으로 닫았습니다. “FL을 줄이는 쪽은 public에서 손해”라는 그동안의 패턴과도 같습니다.
같은 날 시험한 외삽 초과분 재분배(외삽이 큰 영상의 FL을 줄이고 평균을 보존)도 NeuAge에서는 크게 좋아졌지만, 짧은 화면의 FL을 4mm 늘리는 부작용 때문에 관문 +0.0129로 기각했습니다.
(5) 학습형 잔차 보정
4개 구성원의 측정값과 확률 맵 특징으로 “앙상블이 얼마나 틀릴지”를 학습하는 보정 모델(ridge, 그래디언트 부스팅)을 만들었습니다. 장비 단위로 빼고 검증하니 FL과 MT는 모두 나빠졌고, PA만 좋아졌습니다. 그런데 그 PA 이득은 착시였습니다.
- 학습 세트에는 평가자가 잰 스칼라 정답이 없습니다. 정답으로 쓸 수 있는 것은 분할 마스크에서 계산한 기하값뿐입니다.
- 그래서 보정 모델은 “평가자 관례”가 아니라 “마스크 기하”를 배웠습니다. 마스크 기하에 가장 가까운 구성원의 PA를 따라가도록 학습된 것입니다.
- 평가자 정답이 있는 NeuAge에 적용하면 +0.09~+0.17로 크게 나빠졌고, 관문도 0/24였습니다.
평가자 관례를 배우려면 평가자 라벨이 있어야 합니다. 이 대회의 학습 세트로는 그 관례를 배울 수 없습니다.
다관점 리서치 26명의 결론
같은 날 에이전트 26명으로 다관점 리서치를 돌렸습니다. 가설을 내는 쪽과 반박하는 쪽을 나눠, 반박 두 표를 견딘 가설만 남겼습니다. 8개 중 4개가 살아남았습니다(깊이 공변량 PA 보정, 정수 위상 이동 TTA, 큰 백본 구성원 이월, 같은 피험자 좌우 풀링). 네 개의 보수적 기대 이득을 모두 더해도 −0.001~−0.004입니다. 1위와 격차의 5~15%입니다.
그 네 개도 그날 판정했습니다. 깊이 공변량은 로컬 두 세트에서 연관이 실재했지만 한쪽 세트의 계수를 다른 세트에 옮기면 효과가 사라졌습니다. TTA는 세 세트 모두 개선이라는 조건을 못 채웠습니다. 좌우 풀링은 진짜 짝과 무작위 짝의 이득이 같아서, 이득이 짝 정보가 아니라 단순 평균 수축에서 왔습니다. 백본 구성원 이월 하나만 사전 기준을 통과해 다음 날 제출 칸에 올랐습니다.
4. 교훈
상위 팀의 하루 −0.02는 미세 조정이 아닐 가능성이 큽니다. 우리 사흘의 숫자를 모으면 이렇습니다. 상수 곡선의 바닥은 지금 점수와 0.0001 차이입니다. 살아남은 가설을 다 더해도 0.004입니다. 한 번의 제출로 0.018을 줄이려면 FL MAE를 약 0.8mm 한꺼번에 줄여야 합니다. 상수나 TTA로 나오는 폭이 아닙니다. 정답 환산 규약, 평가자 관례를 맞히는 방법, 다발 외삽 방식처럼 측정 정의 자체의 차이에서 왔다고 봅니다(추정). 두 팀이 소수 다섯째 자리까지 같은 점수였다가 같은 날 함께 뛴 것도 공통 출처의 구조적 발견을 시사합니다(추정). 다만 공개 노트북과 토론에는 단서가 없었습니다.
사전 등록 관문은 “닫는 속도”를 줍니다. 이번 사흘에 시험한 후보는 열 개가 넘지만 public 칸을 쓴 것은 축소 곡선 측정뿐이었습니다. 나머지는 판정 기준을 미리 적고, 로컬과 관문에서 실패하면 그 자리에서 닫았습니다. 관문은 구성원 교체에서 public보다 낙관적이었습니다(⑪편). 그렇다면 관문에서조차 크게 나빠지는 후보는 public에서 좋아질 가능성이 더 낮다고 볼 수 있습니다. 하루 5칸뿐인 제출을 아끼면서 다섯 갈래를 하루에 닫을 수 있었던 것은 이 비대칭 덕분입니다. 반대로 관문이 통과시킨 것만 public에 올라가므로, 관문이 보지 못하는 구조적 변화는 처음부터 걸러질 위험도 있습니다. 이 부분은 다음 단계에서 따로 다뤄야 합니다.
오차 예산은 “할 수 없는 것”을 먼저 알려 줍니다. FL 오차의 2/3가 평가자 차이 바닥이라는 숫자 하나로, 분할 모델을 더 키우는 것이 왜 public으로 이어지지 않았는지(⑩·⑪편) 설명됩니다. 모델이 좋아져서 줄일 수 있는 몫은 1/3뿐이고, 그 1/3도 대부분 외삽 영상에 몰려 있습니다.
5. 현황과 남은 계획
- public 9위(10/27 기준). 최고점은 tel12fl85 0.20989 그대로이고, 1위와 0.027, 3위와 0.010 차이입니다.
- 최종 두 판은 {tel12fl85, M3prot50}으로 바꿨습니다. ⑪편에서 추천했던 쌍이고, 이번 축소 곡선에서 과적합 신호가 없어 근거가 조금 강해졌습니다.
- 이번 사흘에 닫은 축: 축소·외삽, 축척, 측정 관례(평균 대 중앙값), 곡선 다발 PA, 끝점 직접 회귀, 외삽 초과분 재분배, 학습형 잔차 보정, 깊이 공변량, 위상 이동 TTA, 좌우 풀링.
- 다음 제출에는 큰 백본 구성원 이월판 두 칸만 넣습니다. 남는 칸은 관문을 통과한 판이 없어 비워 둡니다. 잡음으로 public 최고점을 끌어올려 봐야 private로 이어지지 않기 때문입니다.
- 남은 2주의 큰 줄기는 “측정 정의”입니다. 외삽 영상에서 평가자가 실제로 어떻게 길이를 정하는지를 공개 벤치마크의 평가자 7명 기록으로 더 자세히 보려 합니다.
⑪편이 판정 도구를 의심하는 글이었다면, 이번 글은 그 도구로 할 수 없는 것을 빨리 확인한 기록입니다. 0.02의 벽은 상수 몇 개를 다듬어서 넘을 수 있는 높이가 아니었습니다. 벽을 넘으려면 무엇을 재는지부터 다시 봐야 한다는 것을 이번 사흘의 숫자들이 함께 가리키고 있습니다.