UMUD 챌린지 ⑪ — 내부 판정은 어디까지 믿을 수 있나: 시드 운, 중복 데이터, 최종 쌍
⑩편은 “시드 하나짜리 통과는 믿으면 안 된다”로 끝났습니다. 그 뒤 나흘(10/21~10/24) 동안 그 말이 몇 번 더 확인됐습니다. 이번 글은 새 모델 이야기보다 판정 도구를 얼마나 믿을 수 있는가에 대한 기록입니다. 관문 예측이 public에서 뒤집혔고, 외부 데이터는 대부분 대회 데이터의 사본이었습니다. 큰 모델은 분할만 조금 올렸습니다. 그리고 private 순위를 정할 최종 두 판을 고르는 방법을 다시 세웠습니다.
대회 진행 중이라 코드와 대회 이미지는 싣지 않습니다. 그림은 모두 학습 로그와 판정 기록의 숫자로 직접 그린 차트입니다. “추정”이라고 적은 것은 실측이 아니라 해석입니다.
1. 내부 판정이 틀린 날
⑨편에서 만든 관문은 public 영상별 오차 모형으로 “이 변경을 넣으면 public이 얼마나 바뀔까”를 미리 계산합니다. 오차 모형 3개 × 설정 8가지, 24가지 평가에서 모두 좋아져야 통과입니다. 보정 상수나 셀 이동처럼 측정값을 한 방향으로 옮기는 변경에는 잘 맞았습니다.
분할 구성원에서는 맞지 않았습니다.
| 판 | 관문 예측 Δ | public 실측 Δ | 결과 |
|---|---|---|---|
| ofa4 (방향장 구성원, 4시드 맵 평균) | −0.00270 (24/24) | +0.00050 | 부호가 뒤집힘 |
| hd_mt8 (Hiera + DINOv2 구성원) | −0.00153 | −0.00100 | 방향은 맞고 크기는 약 2/3 |
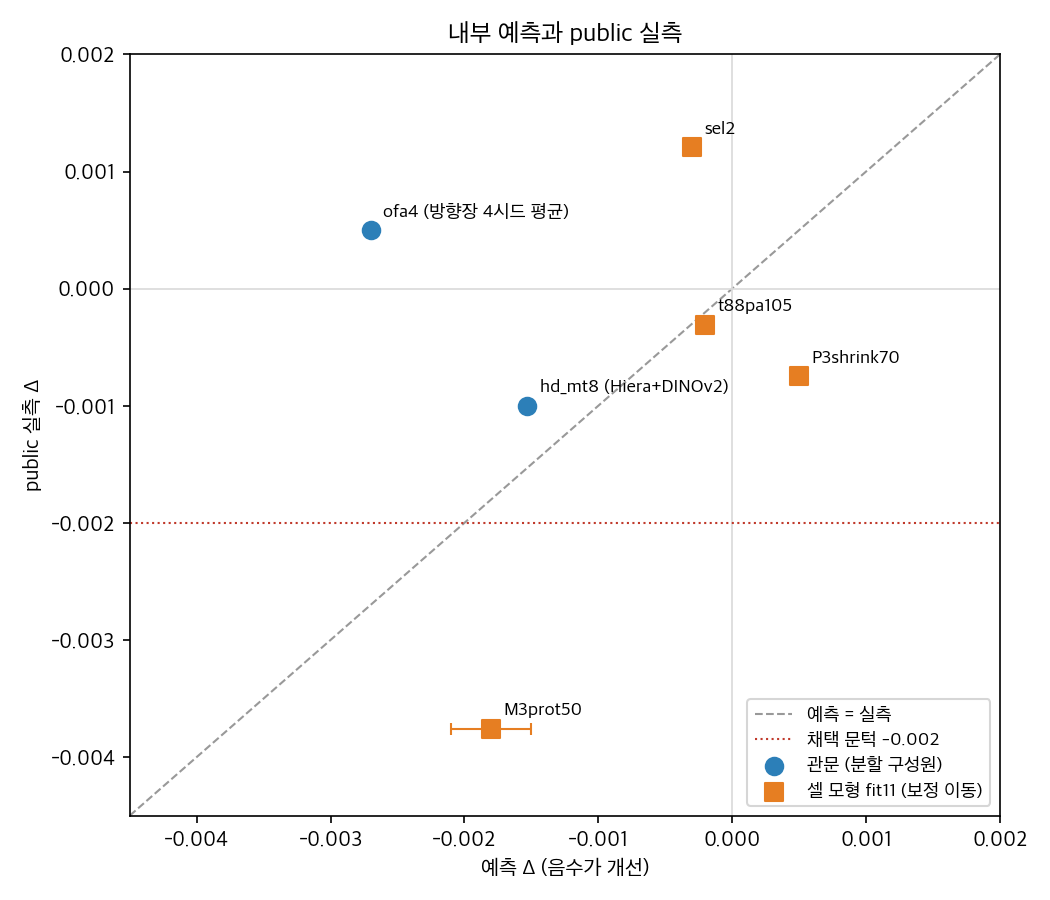 파란 원은 관문 예측, 주황 네모는 같은 기간 셀 이동에 쓴 다른 모형(fit11)의 예측이다. 대각선에 가까울수록 예측이 맞았다. M3prot50의 예측은 −0.0015~−0.0021 범위로 기록돼 있어 가운데에 점을 찍고 범위를 막대로 표시했다
방향장 구성원은 다발을 “선”으로 분할하지 않고, 다발이 있을 법한 띠와 그 안의 방향을 직접 학습한 모델입니다. 시드 하나씩 넣으면 −0.0003~−0.0027로 흔들렸습니다. 사전 등록한 4시드 묶음은 22/24로 불통과였습니다. 그래서 4시드의 예측 맵을 평균해 구성원 하나로 만든 판(ofa4)을 다시 세웠고, 이것이 관문을 크게 통과했습니다. 그런데 public에서는 오히려 나빠졌습니다.
여기서 얻은 교훈은 세 가지입니다.
- 관문은 “측정값을 한 방향으로 옮기는 변경”에만 맞습니다. 분할 구성원처럼 영상마다 측정을 다르게 흩트리는 변경은 예측하지 못했습니다. 오차 모형이 영상 사이 잔차 상관을 담지 못해서라고 봅니다(추정).
- 관문은 public보다 낙관적입니다. hd_mt8 한 건만 봐도 실측이 예측의 약 0.65배였습니다. 시드 분산(±0.001)까지 더하면, 관문을 겨우 통과한 판이 public 채택 문턱(−0.002)을 넘기는 어렵습니다.
- 사후 가설은 한 번 더 깎아서 봐야 합니다. ofa4는 묶음 불통과를 본 뒤 세운 가설이었습니다. 이미 결과를 본 상태에서 고른 판이라 선택 편향이 겹쳤습니다(추정).
결론으로 분할 구성원 축은 public 기준으로 닫았습니다. 10/20~22에 학습한 백본·다발 실험(Hiera, DINOv2, ConvNeXt, 고해상도 Hiera, 방향장, 각도 기준 체크포인트, Tversky 손실 등)은 모두 public 이득 근거가 없습니다. 이 결과 뒤로는 관문 통과만으로 쓸 근거가 없다고 보고, 형식상 통과한 VGG16 방향장판(−0.00174, 24/24)도 쓰지 않았습니다.
2. 시드 운
⑩편의 Hiera 사례가 예외가 아니었습니다. 단일 시드로 통과한 모델은 시드를 늘리자 모두 무너졌습니다.
| 모델 | 처음 통과한 판 | 시드를 늘린 뒤 |
|---|---|---|
| Hiera-B+ (SAM 2) | s0 −0.00152 (24/24) | 4시드 Δ −0.00152 / −0.00107 / +0.00027 / −0.00028, 평균 −0.0007. 4판 묶음 −0.00062 (20/24) 불통과 |
| 고해상도 Hiera (hr) | s0 −0.00152, s1 −0.00154 (둘 다 24/24) | s2 +0.00065 (2/24), s3 −0.00063 (23/24). 4판 묶음 −0.00116 (23/24) 불통과 |
| 각도 기준 체크포인트 (angsel) | s0 −0.00210 (24/24) | s1 +0.00051 (1/24), s2 −0.00073. 2시드 묶음 −0.00118 문턱 미달 |
| EfficientNet-B5 UNet++ | s0+s1 −0.00142 (24/24) | s2+s3 +0.00029 (4/24) |
B5 사례가 가장 분명합니다. 설정이 완전히 같고 시드만 다른 두 쌍이 각각 통과와 불통과로 갈렸습니다. 고해상도 Hiera는 두 시드가 같은 값으로 통과해서 “재현됐다”고 생각했지만, 그 두 시드도 운이 좋은 쪽이었습니다.
또 하나 반복된 현상이 있습니다. 같은 구성원을 여러 판 넣으면 한 판보다 나빠집니다.
- 방향장 4시드를 각각 따로 넣은 판(mt10): −0.00176 (22/24). 시드별 단독 평균은 −0.0016으로 비슷한데 통과 수가 줄었습니다
- 방향장 s8, s9: 한 판씩은 −0.00157, −0.00150. 두 판을 함께 넣으면 −0.00097 (22/24)
- 방향장 + Hiera 2시드: 한 판씩은 −0.00152, −0.00181. 함께 넣으면 −0.00115 (23/24)
지금 파이프라인은 구성원들의 측정값을 영상마다 중앙값으로 묶습니다. 중앙값에서 이득을 주는 것은 “다르게 틀리는 소수 의견 하나”입니다. 같은 모델을 여러 판 넣으면 그 소수 의견이 다수가 되면서 중앙값이 그쪽으로 기웁니다(추정). 판을 늘리는 대신 맵을 평균해 한 판으로 넣은 것이 ofa4였는데, 1절에서 본 대로 public에서는 그것도 이득이 없었습니다.
그래서 판정 규칙을 다시 고정했습니다. 단일 시드나 사후 조합 통과는 채택 근거가 아닙니다. 묶음 기준은 결과를 보기 전에 정하고, 구성원 변경은 public 실측까지 확인해야 채택합니다.
3. 외부 데이터의 실체
큰 모델을 학습하기 전에 외부 데이터로 사전학습하는 안을 검토했습니다. 공개된 근육 초음파 분할 데이터를 대회 데이터와 pHash(영상 지각 해시)로 대조한 결과는 이렇습니다.
| 세트 | 후보 | 대회 학습 영상과 근사 중복 (pHash ≤10) | 남은 장수 |
|---|---|---|---|
| FALLMUD Cronin | 309 | 304 (≤4는 231) | 5 → 보수적으로 전부 제외 |
| DL_Track 학습 세트 | 근막 121 / 다발 89 | 115 / 84 | 11 |
| FALLMUD Cunningham | 504 | 0 | 504 프레임 |
Cronin은 309장 중 304장이 대회 학습 영상과 사실상 같은 영상이었습니다. DL_Track 학습 세트도 대부분 겹칩니다. 대회 데이터가 이런 공개 세트를 모아 만들어진 것으로 보입니다(추정). 남은 Cunningham 504장은 비복근 영상 8개 시퀀스의 연속 프레임입니다. 이웃 프레임끼리 pHash 거리가 2라서 같은 기준(≤10)으로 세트 안 중복을 빼면 43장만 남습니다. 서로 다른 장면은 느슨하게 세어도 43~127장입니다.
pHash 거리 2~10의 애매한 구간에 있던 Cronin 91장은 픽셀 단위로 다시 판정했습니다. 두 영상을 같은 크기로 맞추고 구조 유사도(SSIM)를 쟀습니다.
- 기준: 해시가 완전히 같은 Cronin 213장은 SSIM 중앙값 1.000(최소 0.855). 장비가 다른 Cunningham 최근접 70쌍은 중앙값 0.141(최대 0.161)
- 애매한 91장: SSIM 0.9 이상 11장, 0.8~0.9 1장 → 12장만 진짜 중복
- 나머지 79장(중앙값 0.5 안팎)은 같은 장비·같은 세션의 다른 프레임이나 다른 위치였습니다
교훈은 두 가지입니다. pHash는 “같은 세션”을 잘 잡지만 “같은 영상”인지는 따로 확인해야 합니다. 그리고 대회 데이터와 같은 세션에서 나온 영상은 픽셀이 달라도 새 장면이 아닙니다. 검증 세트와 겹치면 점수를 부풀리고, 학습에 넣어도 정보가 거의 늘지 않습니다.
남은 515장(Cunningham 504 + DL_Track 11)으로 100 epoch 사전학습을 한 뒤 대회 데이터로 200 epoch 미세조정한 판(A)을 같은 설정의 대조군(B5)과 비교했습니다. 결과를 보기 전에 등록한 네 조건 중 세 개를 충족하지 못했습니다.
| 조건 | A (사전학습) | B5 (대조군) | 판정 |
|---|---|---|---|
| 검증 Dice 근막 / 다발 | 0.8454 / 0.2247 | 0.8479 / 0.2309 | 불충족 |
| 다발 방향 오차 (골격 기준 중앙값) | 1.00° | 0.97° | 불충족 |
| 로컬 Δ bench / clean10 / NeuAge | −0.0019 / −0.0065 / −0.0144 | −0.0005 / −0.0040 / −0.0151 | 불충족 (NeuAge) |
| 관문 | −0.00064 (24/24) | −0.00142 (24/24) | 형식상 통과 |
한 장비·한 근육에서 나온 수십 장면으로는 미세조정 200 epoch 뒤에 남는 이득이 없었습니다. 오히려 다발이 더 일찍 과적합했습니다(4절). 10/1에 FALLMUD와 DL_Track을 학습에 섞었을 때 다른 장비 세트(NeuAge)가 크게 나빠졌던 결론과 같습니다. 외부 사전학습 축은 여기서 닫았습니다.
4. 큰 모델: 분할은 조금 오르고, 측정은 그대로
GPU 여덟 장을 모두 써서 UNet++에 EfficientNet-B5와 B7 인코더를 붙이고 방향 헤드와 함께 200 epoch 학습했습니다. 두 시드의 맵을 평균한 구성원 기준 검증 Dice는 이렇습니다.
| 구성원 | 근막 Dice | 다발 Dice |
|---|---|---|
| B7 (2시드 평균) | 0.8486 | 0.2304 |
| B5 (2시드 평균) | 0.8479 | 0.2309 |
| B5 다른 시드 쌍 (s2+s3) | 0.8461 | 0.2261 |
| EfficientNet-B3, 80 epoch (기존) | 0.8408 | 0.2254 |
| ResNet-34, 60 epoch (기존 기준) | 0.8270 | 0.2176 |
분할은 기존 기준보다 근막 +0.02, 다발 +0.013 정도 올랐습니다. 측정은 그렇지 않았습니다. 관문은 2절 표대로 시드에 따라 통과와 불통과가 갈렸습니다(B7 2시드 묶음 +0.00023, 5/24). 로컬 NeuAge는 EfficientNet 계열 모두 −0.010~−0.016으로 좋아 보였습니다. 하지만 로컬 개선이 관문과 public으로 이어지지 않는 패턴은 그동안 계속 반복됐습니다. ⑩편의 “Dice와 측정 기여는 따로 논다”가 큰 모델에서도 그대로였습니다.
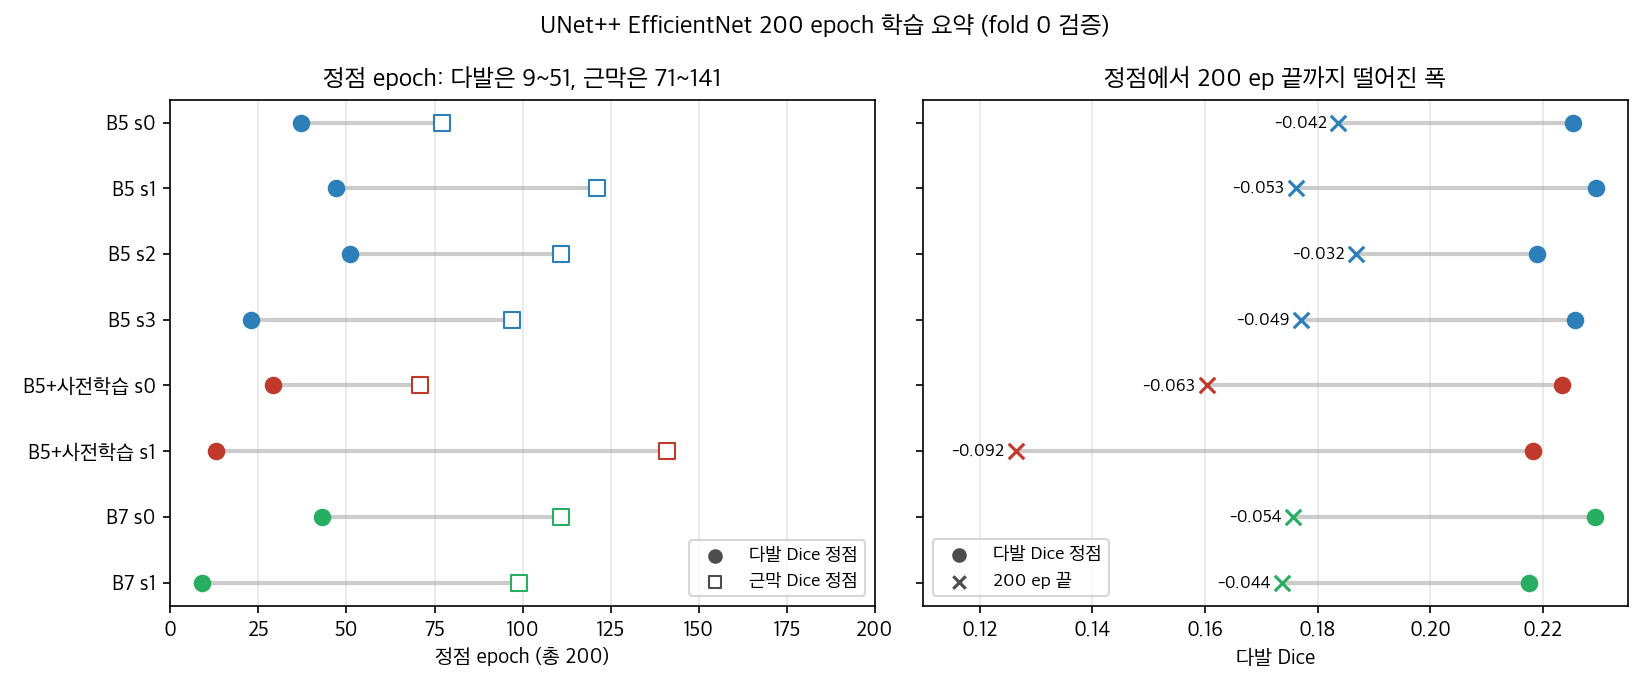 왼쪽은 판마다 다발·근막 Dice가 정점을 찍은 epoch, 오른쪽은 다발 Dice가 정점에서 200 epoch 끝까지 떨어진 폭이다
학습 곡선에서 가장 눈에 띄는 것은 다발의 정점이 아주 이르다는 점입니다.
- 근막은 71~141 epoch에서 정점을 찍고, 200 epoch까지 거의 그대로입니다.
- 다발은 9~51 epoch에서 정점을 찍고 그 뒤 계속 떨어집니다. 200 epoch 끝에서는 정점보다 0.03~0.09 낮습니다.
- 외부 사전학습판은 더 일찍, 더 많이 떨어집니다(s1은 13 epoch 정점, 끝에서 −0.092).
다발 라벨은 몇 픽셀 두께의 듬성한 선이라 모델이 금방 외워 버리는 것으로 보입니다(추정). 근막과 다발이 같은 인코더를 쓰는데 최적 시점이 이렇게 다르니, 체크포인트를 과제별로 따로 저장해 둔 것이 실제로 쓰였습니다. 학습을 길게 해서 이득을 보는 쪽은 근막뿐이었고, 그 근막은 이미 포화돼 있었습니다.
5. 최종 두 판을 고르는 방법
Kaggle에서 private 순위는 직접 고른 최종 두 판 중 private 점수가 좋은 쪽으로 정해집니다. 그래서 두 판은 각각 좋아야 하고, 동시에 서로 다르게 틀려야 보험이 됩니다. 문제는 “얼마나 다르게 틀리는가”를 지금까지 모형으로만 추정했다는 점입니다.
혼합판으로 오차 상관 재기
10/23 제출 다섯 칸을 이 측정에 썼습니다. 두 판의 측정값을 영상마다 평균한 혼합판을 내면, 혼합판 점수와 두 판의 점수로 두 판의 오차 상관 ρ를 거꾸로 풀 수 있습니다. 영상별 오차가 평균 0인 정규분포라고 가정하면 이렇게 됩니다.
\[\rho = \frac{4S_m^2 - S_A^2 - S_B^2}{2\,S_A S_B}\]여기서 $S_A$, $S_B$는 두 판의 점수, $S_m$은 혼합판 점수입니다.
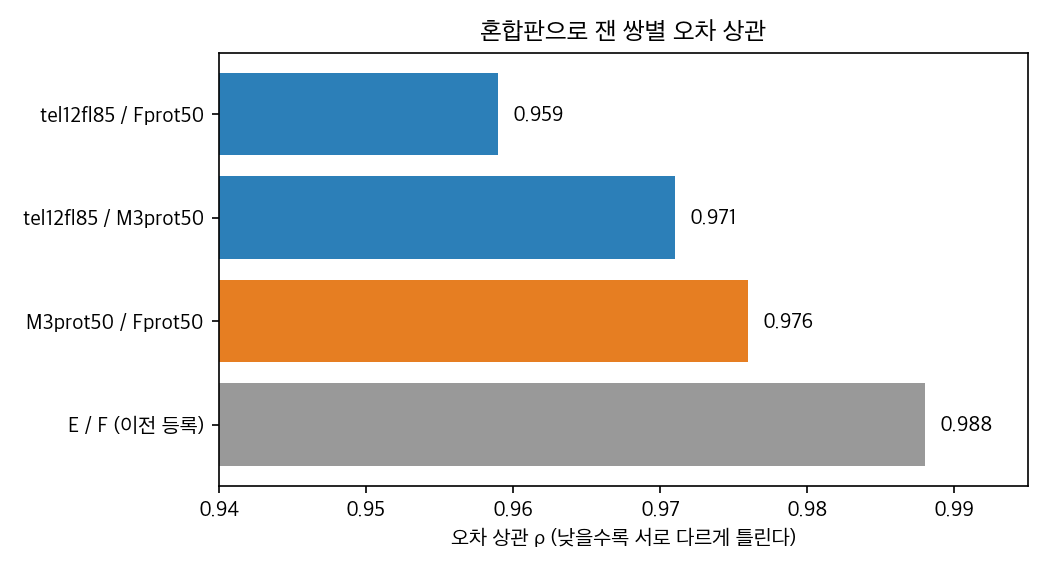 혼합판 네 개로 잰 쌍별 ρ. 정답 잡음을 두 판이 공유하므로 모두 1에 가깝게 나온다. 절댓값보다 쌍끼리 순위로 읽는다
| 쌍 | 두 판 public | 혼합판 public | ρ |
|---|---|---|---|
| tel12fl85 / Fprot50 | 0.20989 / 0.22751 | 0.21644 | 0.959 |
| tel12fl85 / M3prot50 | 0.20989 / 0.21726 | 0.21201 | 0.971 |
| M3prot50 / Fprot50 (현재 등록) | 0.21726 / 0.22751 | 0.22102 | 0.976 |
| E / F (이전 등록) | 0.22868 / 0.23042 | 0.22885 | 0.988 |
이전에 등록해 두었던 {E, F}가 가장 비슷하게 틀리는 쌍이었습니다. 혼합판은 모두 두 판 중 좋은 쪽보다 나빴습니다. 혼합 자체로 public 점수를 올릴 수는 없었습니다.
FL 차이 분해
같은 날 다섯 번째 칸에는 PA는 M3prot50에서, FL과 MT는 Fprot50에서 가져온 판(xPA)을 냈습니다. 그 결과 두 판은 거의 FL에서만 갈린다는 것이 확인됐습니다(PA 차 +0.0005, FL·MT 차 −0.01075).
10/24에는 이 FL 차이 0.01075가 어디서 오는지 Fprot50에서 M3prot50 쪽으로 한 요소씩 옮겨 가며 나눴습니다.
| 요소 | 몫 |
|---|---|
| ResNet-34 6판 중앙값 (mt6) | −0.0019 |
| FL 결합 항 (couple) | −0.0043 |
| 나머지 (결합에 쓰는 PA의 당김·투표) | −0.0046 |
세 몫이 비슷합니다. 한 요소가 아니라 M3 경로 전체가 FL을 더 잘 맞춥니다. 같은 실험에서 mt6 효과는 경로에 따라 달랐습니다(F 경로 −0.0019, M3 경로 −0.0041). FL을 다발과 근막의 교점만으로 계산하는 규칙은 크게 나빠져(+0.0265, +0.0067) 기각했습니다. 평가자의 FL은 교점 외삽만이 아닙니다.
두 판을 어떻게 고르나
실측 ρ로 두 판 점수 차가 public 102장/private 207장 분할에서 얼마나 흔들리는지(분할 잡음)를 바로 계산했습니다. {M3prot50, Fprot50}은 0.0071, {tel12fl85, M3prot50}은 0.0058입니다. 그리고 두 관점에서 쌍을 비교했습니다.
- flat 관점: public 차가 private에도 그대로 이어진다고 봅니다. 다만 tel12fl85는 수십 판 중 최고를 고른 값이라(Δ −0.00146, 잡음 구간) 승자의 저주 벌점을 줍니다.
- model 관점: 셀 이동 모형의 사후 평균을 씁니다.
두 관점 중 나쁜 쪽에서 1위 쌍 대비 “private 1위 확률”을 얼마나 잃는지(최대 후회)로 줄을 세웠습니다. 모두 모형 추정입니다.
| 쌍 | 최대 후회 |
|---|---|
| {tel12fl85, M3prot50} | 0.008 |
| {tel12fl85, Fmt6c} | 0.011 |
| {M3prot50, Fmt6c} | 0.034 |
| {M3prot50, Fprot50} (현재 등록) | 0.035 |
{tel12fl85, M3prot50}은 승자의 저주 벌점을 0.0106까지 키워도 flat 관점에서 1위입니다. model 관점에서는 1위보다 0.005~0.008 낮습니다. 어느 한 관점을 믿지 않아도 크게 잃지 않는 쌍입니다. 반대로 지금 등록한 {M3prot50, Fprot50}의 보험 가치는 대부분 “private에서 두 판 차가 줄어든다”는 셀 모형에 대한 믿음에서 나옵니다.
다만 최종 쌍을 바꾸는 것은 사용자 승인 사항이라 지금은 바꾸지 않았습니다. 추천 순서와 근거 강도(중간)만 기록해 두었습니다. tel12fl85는 제출 스크립트로 바이트 단위 재현까지 확인했습니다.
6. 현황과 남은 계획
- public 6위(10/24 09:15 기준). 최고점은 10/21의 tel12fl85 0.20989이고, 1위(0.20036)와 0.0095 차이입니다. 10/21에는 4위였는데 그 뒤 갱신이 없는 사이 두 팀이 앞섰습니다.
- 이번 주에 닫은 축: 분할 구성원(public 근거 없음), 방향장 변형, TEL1200 FL 수축(0.70은 +0.0053), 외부 사전학습, 교점 FL 규칙.
- 10/25 제출에는 B5 4시드 맵 평균 구성원 한 칸을 넣습니다. 채택 문턱(Δ ≤ −0.002)은 미리 정해 두었습니다. 1절의 교훈대로 관문 숫자가 아니라 public 실측으로 판단합니다.
- FL 경로에서는 Fmt6c(F 경로에 M3식 FL 요소를 옮긴 판)가 Fprot50보다 public −0.0062로 채택 문턱을 넘었습니다. 다만 M3prot50과 가까워져 보험 판으로서는 거의 중립입니다. 최종 쌍에 쓰려면 먼저 제출 스크립트로 바이트 재현해야 합니다.
- 최종 두 판은 11/13까지 Kaggle 화면에서 직접 체크해야 합니다. 그 전에 쌍 교체 여부를 결정하고, 고른 두 판을 제출 스크립트로 바이트 재현합니다.
이번 나흘의 결론은 ⑩편보다 한 걸음 더 나갔습니다. 시드 하나를 믿으면 안 되는 것처럼, 판정 도구 하나도 믿으면 안 됩니다. 관문은 보정 이동에는 맞고 분할 구성원에는 틀렸습니다. pHash는 같은 세션은 잡지만 같은 영상인지는 SSIM으로 확인해야 했습니다. 쌍의 다양성도 모형으로 추정하던 것을 혼합판으로 실제로 재 보니 추천 쌍이 바뀌었습니다. private으로 순위가 정해지는 대회에서 마지막 3주는 새 점수보다 이런 확인에 쓰는 편이 낫다고 판단합니다.