포스터 수치 되찾기 — 재현을 막고 있던 건 모델이 아니었다
앞선 글에서 SITL 재구성 네트워크를 PyTorch로 이식했지만, 성능은 포스터에 한참 못 미쳤습니다. 목표는 RMSE 1.556% / SSIM 0.983 / PSNR 36.60 dB인데 10.5% / 0.618 / 19.7 dB가 나왔습니다. 고전 알고리즘인 MLEM에게도 졌습니다.
이번 글은 그 격차를 좁혀간 기록입니다. 결론부터 적으면 이렇게 됐습니다.
| RMSE | SSIM | PSNR | |
|---|---|---|---|
| 재현 결과 | 1.618% | 0.987 | 37.04 dB |
| 포스터 원 결과 | 1.556% | 0.983 | 36.60 dB |
SSIM과 PSNR은 넘었고 RMSE만 4% 차이입니다. 테스트셋 15,787장 기준입니다.
그런데 이 글에서 정작 하고 싶은 이야기는 수치가 아닙니다. 무엇이 성능을 결정하는지 순서를 잘못 짚고 있었다는 쪽입니다.
첫 번째 오진 — “데이터가 부족한 거겠지”
처음 결과가 나빴을 때 저는 데이터 부족이라고 단정했습니다. 원 연구는 MS COCO 전체 (118,287장)로 학습했는데 저는 343장만 쓰고 있었으니까요. 블로그에도 그렇게 썼습니다.
틀렸습니다. 확인 방법은 간단했습니다.
1
train 10.25%    val 10.83%    test 10.52%
본 적 있는 데이터와 없는 데이터의 성능이 같았습니다. 과적합이 전혀 없다는 뜻이고, 데이터가 부족해서 못 맞추는 게 아니라 학습 데이터조차 못 맞추고 있다는 뜻입니다.
데이터가 병목이면 train과 val 사이가 벌어집니다. 그걸 안 보고 “데이터가 적으니 데이터 문제겠지”라고 넘어간 것이 첫 번째 오진이었습니다.
성능이 안 나올 때 train/val 격차부터 볼 것. 격차가 크면 데이터, 둘 다 나쁘면 용량이나 입력 자체의 문제입니다.
두 번째 오진 — “그럼 모델이 작은 거겠지”
과적합이 없으니 용량 문제라고 판단했습니다. Post-ConvL을 C3에서 C4로 늘렸습니다.
1
2
C3 (247,267 파라미터)  →  9.76%
C4 (349,731 파라미터)  →  9.61%
파라미터를 42% 늘렸는데 1.5% 좋아졌습니다. 방향은 맞지만 이 속도로는 6배 격차를 못 메웁니다. 용량도 주범이 아니었습니다.
진짜 원인 — 입력 사이노그램의 잡음
남은 건 입력이었습니다. 우리 데이터의 잡음 수준을 재봤습니다.
1
64×64 : bin당 21.3 counts  →  상대잡음 21.7%
그리고 원본 train.py에는 유효 계수 범위가 (2e5, 8e6)으로 남아 있었는데, 우리 데이터는 343장 중 97장만 그 범위 안에 들었습니다. 의도한 것보다 훨씬 잡음이 심한 데이터로 학습하고 있었던 것입니다.
원인은 제 전처리 기본값이었습니다. 사이노그램 값을 그대로 계수로 쓰는 방식 (--count-scaling none)을 썼는데, 이러면 해상도에 따라 잡음이 달라집니다.
| 해상도 | bin당 계수 | 상대잡음 |
|---|---|---|
| 64×64 | 21.3 | 21.7% |
| 512×512 | 183.0 | 7.4% |
같은 코드인데 64는 잡음이 과하고 512는 적당했습니다. 광선이 지나는 픽셀 수가 해상도에 비례하니 당연한 결과인데, 처음엔 눈치채지 못했습니다.
잡음만 바꿔 다시 측정했습니다.
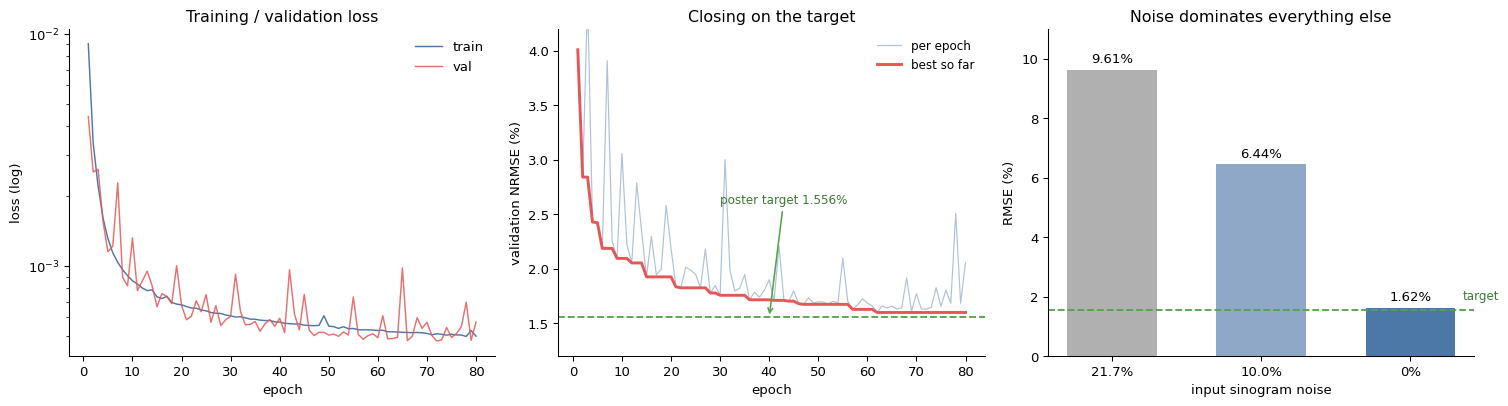 왼쪽: 학습 곡선. 가운데: 목표선을 향해 내려가는 검증 NRMSE. 오른쪽: 입력 잡음만 바꿨을 때의 RMSE
| 잡음 | RMSE | SSIM |
|---|---|---|
| 21.7% | 9.61% | 0.705 |
| 10.0% | 6.44% | 0.834 |
| 0% | 1.62% | 0.987 |
구조도 데이터 수도 그대로인데 6배가 갈렸습니다. 용량을 42% 늘려 얻은 1.5%와 비교하면 차원이 다릅니다.
이후로는 --counts-per-bin 옵션을 만들어 잡음 수준을 해상도와 무관하게 직접 지정하도록 바꿨습니다. 애초에 이렇게 했어야 했습니다.
데이터도 물론 효과가 있었습니다
데이터가 주범은 아니었지만, 잡음을 잡고 나니 제 역할을 했습니다. COCO 전체 157,875장(학습 126,301장)으로 늘렸더니:
1
2
275장 / 400 epoch  →  7.81%
126,301장 / 5 epoch →  7.76%
5 epoch 만에 이전 400 epoch 결과를 넘었습니다. 다만 이건 잡음을 함께 낮춘 상태에서의 이야기입니다. 잡음이 21.7%였을 때는 데이터를 116배 늘려도 벽이 있었습니다.
구조는 층 수가 아니라 수용 영역
용량 실험을 다시 해봤습니다. 이번엔 커널 크기와 dilation까지 넣어서요.
| 구성 | 수용 영역 | val NRMSE (동일 epoch) |
|---|---|---|
| C4 5×5 | 19px | 7.52% |
| C5 5×5 | 23px | 7.14% |
| C4 7×7 | 25px | 6.98% |
| C5 7×7 | 31px | 6.82% |
| C5 7×7 dilation 4 | 55px | 포화 |
| C6 7×7 dilation 4 | 79px | 포화 |
성능이 파라미터 수가 아니라 수용 영역 순서를 따라갑니다. C5 5×5(452K 파라미터, 23px)보다 C4 7×7(571K, 25px)이 낫고, 이건 층을 하나 줄이고 커널을 키운 쪽입니다.
이유는 오차 영상을 보면 짐작이 갑니다. SITL이 만드는 아티팩트가 영상을 가로지르는 긴 줄무늬라, 이걸 지우려면 그만큼 넓게 볼 수 있어야 합니다. 다만 영상 크기의 절반(31px / 64px)을 넘으면 포화했습니다. dilation으로 55px, 79px까지 넓혀도 더는 좋아지지 않았고, 오히려 dilation 자체가 격자 아티팩트를 만드는 듯했습니다.
결과
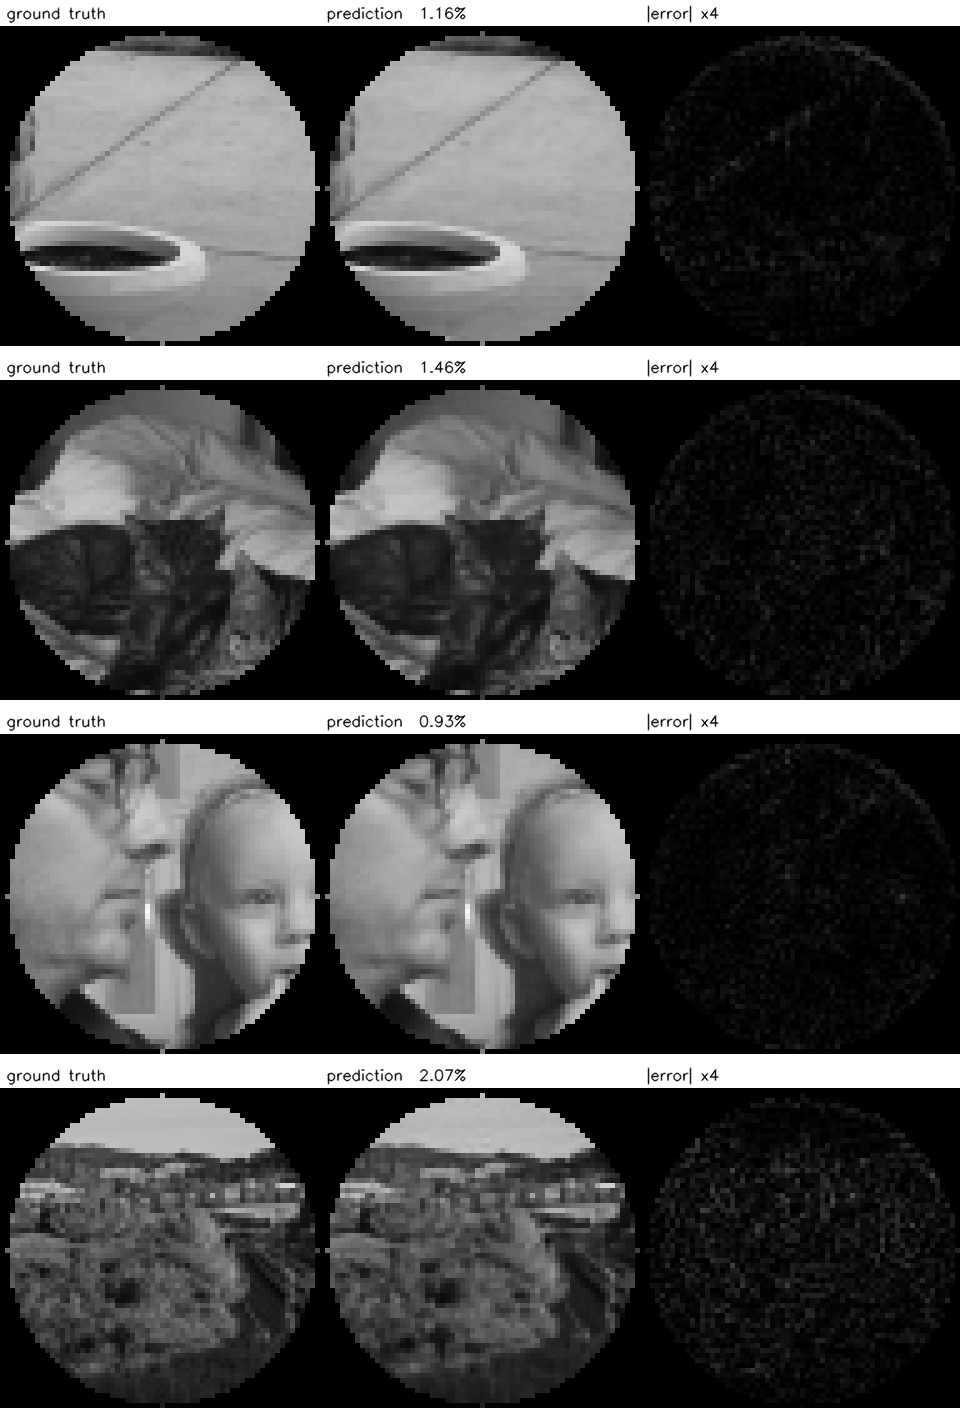 왼쪽부터 정답, 예측, 오차×4. 오차 영상이 거의 검습니다
인물 얼굴, 고양이 털, 바위 질감까지 살아났습니다. 이전 글에서 보였던 격자 아티팩트는 사라졌습니다.
최종 구성은 이렇습니다.
1
2
C5-SITL-C5,  post 커널 7×7,  수용 영역 31px,  771,683 파라미터
MS COCO 157,875장 (train 126,301),  80 epoch
남은 것
정직하게 적자면, 무노이즈 입력에서의 결과입니다. 잡음 10%를 넣으면 6.44%가 한계였습니다. 포스터가 어느 조건에서 1.556%를 얻었는지는 명시되어 있지 않아, 두 조건을 모두 측정해 나란히 적었습니다.
RMSE 1.618%는 목표 1.556%에 4% 못 미칩니다. 더 돌리면 닿을 것 같지만 거기까지 확인하지는 않았습니다.
정리
세 번의 판단 중 두 번을 틀렸습니다.
- 데이터 부족 — 아니었습니다. train/val 격차를 안 봤습니다
- 모델 용량 — 아니었습니다. 42% 늘려 1.5% 얻었습니다
- 입력 잡음 — 맞았습니다. 이것만 바꿔 6배가 갈렸습니다
되짚어보면 순서가 잘못됐습니다. 모델을 건드리기 전에 입력 데이터가 의도한 대로 만들어졌는지 확인했어야 했습니다. 원본 코드에 total_cnt_range = (2e5, 8e6)이 버젓이 적혀 있었는데, 제 데이터가 그 범위를 벗어난다는 걸 한참 뒤에야 알았습니다.
남이 만든 파이프라인을 복원할 때는, 남아 있는 숫자 하나하나가 왜 거기 있는지 먼저 물어보는 편이 빠른 것 같습니다.
코드는 GitHub에 있습니다.