무엇이 재구성 품질을 결정하는가 — 잡음, 수용 영역, 그리고 해상도
앞선 글에서 SITL 재구성 네트워크로 포스터 수치를 재현했습니다. 이번 글은 그 다음 질문들에 답한 기록입니다.
- 무엇이 성능을 결정하는가 — 잡음? 모델 크기? 데이터?
- Post-ConvL은 정말 de-blurring과 de-noising을 둘 다 하는가?
- 해상도를 올리면 어떻게 되는가?
측정 결과를 그림 위주로 정리했습니다.
1. 잡음이 압도적입니다
같은 구조, 같은 데이터에서 입력 사이노그램의 잡음만 바꿔봤습니다.
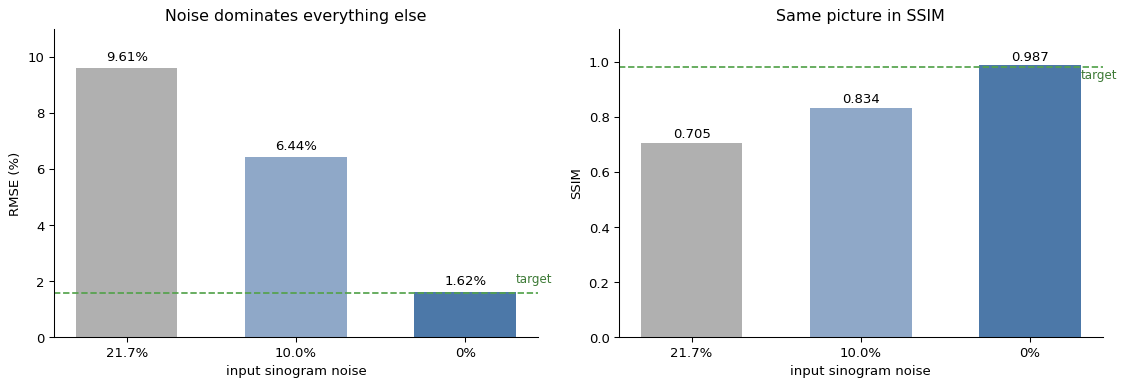 잡음만 바꿨을 때의 RMSE(왼쪽)와 SSIM(오른쪽). 점선은 포스터 목표치
| 잡음 | RMSE | SSIM |
|---|---|---|
| 21.7% | 9.61% | 0.705 |
| 10.0% | 6.44% | 0.834 |
| 0% | 1.62% | 0.987 |
6배가 갈립니다. 참고로 모델 파라미터를 42% 늘려 얻은 개선은 1.5%였습니다. 차원이 다릅니다.
잡음 수준이 제멋대로였던 이유는 전처리 기본값 때문이었습니다. 사이노그램 값을 그대로 계수로 쓰면 해상도에 따라 잡음이 달라집니다 — 광선이 지나는 픽셀 수가 해상도에 비례하니까요.
| 해상도 | bin당 계수 | 상대잡음 |
|---|---|---|
| 64×64 | 21.3 | 21.7% |
| 512×512 | 183.0 | 7.4% |
같은 코드인데 64는 잡음이 과했습니다. 지금은 --counts-per-bin 으로 해상도와 무관하게 직접 지정합니다.
2. 성능은 파라미터가 아니라 수용 영역을 따릅니다
Post-ConvL의 층 수, 커널 크기, dilation을 바꿔가며 측정했습니다.
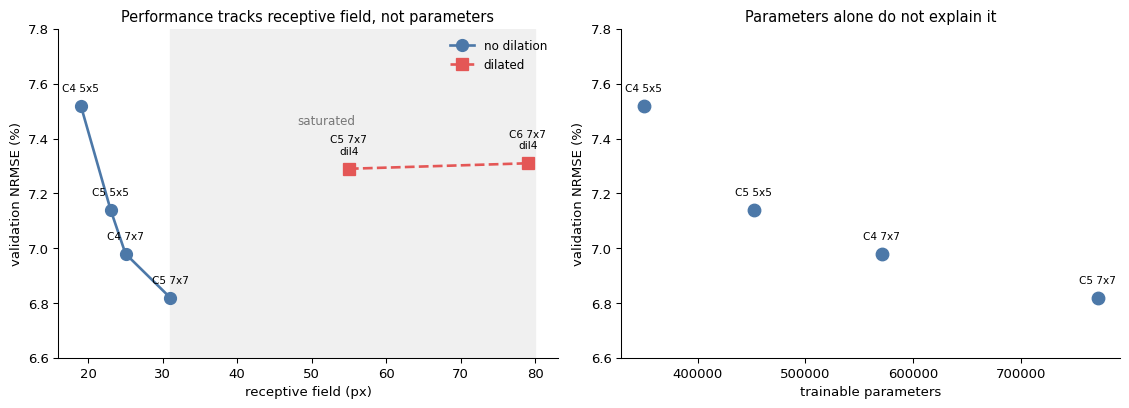 왼쪽: 수용 영역 대비 성능. 오른쪽: 같은 데이터를 파라미터 축으로 본 것
| 구성 | 수용 영역 | 파라미터 | val NRMSE |
|---|---|---|---|
| C4 5×5 | 19px | 349,731 | 7.52% |
| C5 5×5 | 23px | 452,195 | 7.14% |
| C4 7×7 | 25px | 570,915 | 6.98% |
| C5 7×7 | 31px | 771,683 | 6.82% |
| C5 7×7 dilation 4 | 55px | 771,683 | 7.29% |
| C6 7×7 dilation 4 | 79px | 972,451 | 7.31% |
C5 5×5(452K, 23px)보다 C4 7×7(571K, 25px)이 낫습니다. 층을 하나 줄이고 커널을 키운 쪽인데, 수용 영역 순서와 성능 순서가 정확히 일치합니다.
SITL이 만드는 아티팩트가 영상을 가로지르는 긴 줄무늬라, 넓게 봐야 지울 수 있습니다. 다만 영상 크기의 절반(31px / 64px)을 넘으면 포화했습니다. dilation으로 55px, 79px까지 넓혀도 더 좋아지지 않았고, 오히려 dilation 자체가 격자를 만드는 듯했습니다.
3. Post-ConvL은 정말 둘 다 합니다
포스터는 Post-ConvL이 “de-blurring과 de-noising을 동시에 수행”한다고 적고 있습니다. 같은 모델 안에서 SITL 직후와 최종 출력을 비교해 확인했습니다.
디블러링 (무노이즈 입력)
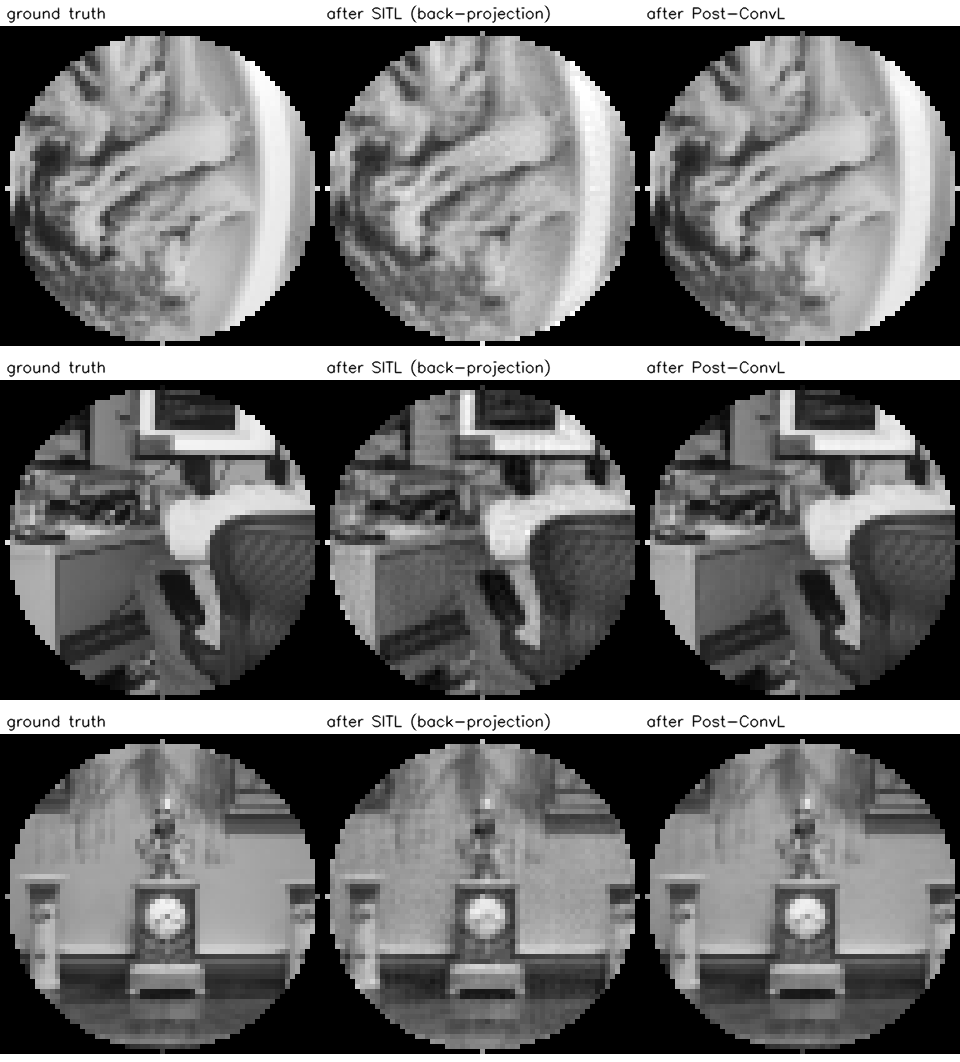 왼쪽부터 정답, SITL 직후(역투영 수준), Post-ConvL 통과 후
| 단계 | RMSE | SSIM | PSNR |
|---|---|---|---|
| SITL 직후 | 4.590% | 0.944 | 27.62 dB |
| Post-ConvL 후 | 1.625% | 0.987 | 36.85 dB |
SITL은 본질적으로 역투영이라 결과가 흐립니다. 가운데 영상의 뿌연 느낌이 오른쪽에서 걷히는 게 보입니다. 오차 기준 2.8배, PSNR +9.23 dB 입니다.
디노이징 (잡음 10% 입력)
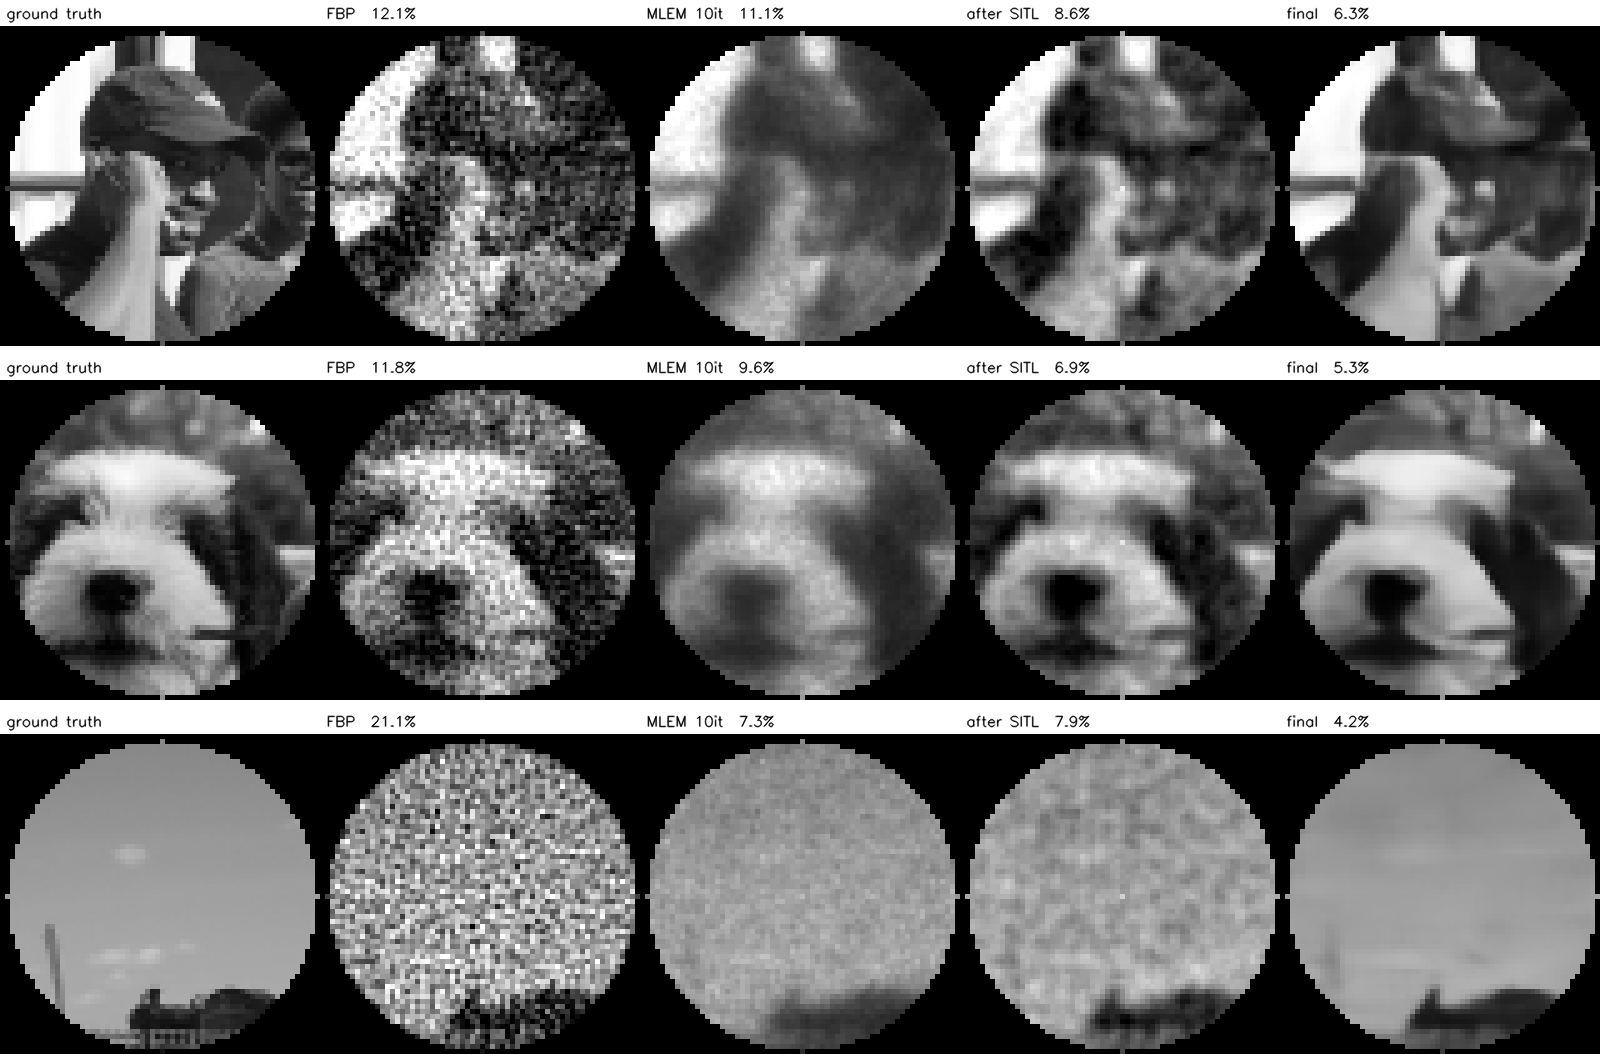 왼쪽부터 정답, FBP, MLEM 10회, SITL 직후, 최종 출력
| 방법 | RMSE | SSIM | PSNR |
|---|---|---|---|
| FBP | 13.589% | 0.600 | 18.27 dB |
| MLEM (10 iter) | 9.552% | 0.699 | 21.35 dB |
| SITL 직후 | 8.449% | 0.756 | 22.26 dB |
| 최종 출력 | 6.258% | 0.844 | 25.01 dB |
FBP는 잡음이 그대로 드러나고, MLEM은 깨끗하지만 뭉갭니다. 네트워크는 둘 다를 앞섭니다. 이전 재현 시도에서 MLEM에게 졌던 것과 대조적인데, 그때는 잡음 설정이 잘못돼 있었습니다.
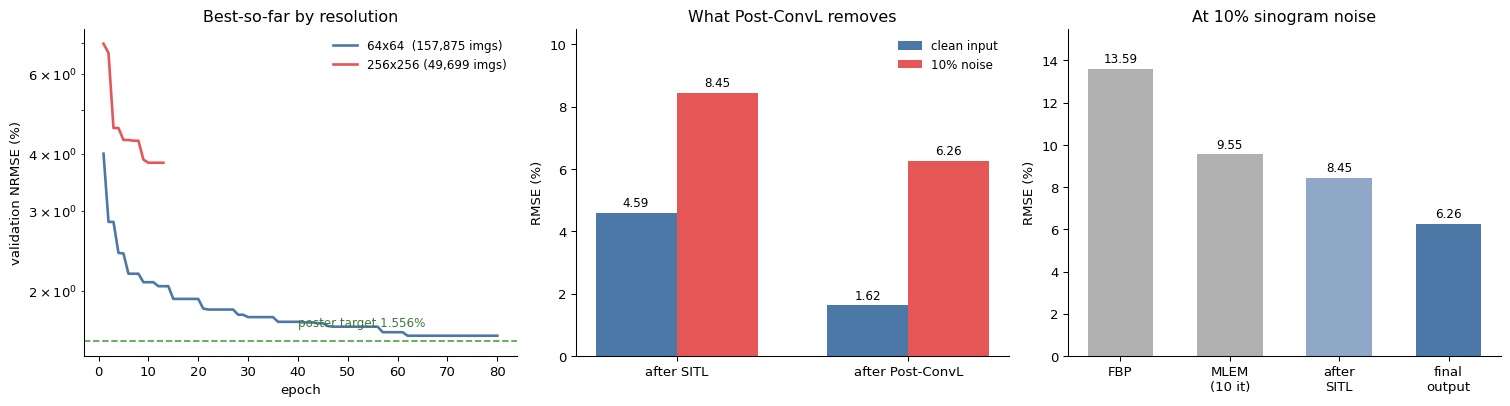 왼쪽: 해상도별 수렴 곡선. 가운데: Post-ConvL이 걷어내는 양. 오른쪽: 잡음 조건에서 고전 알고리즘 대비
4. 해상도를 올리면
같은 구조로 256×256까지 올려봤습니다.
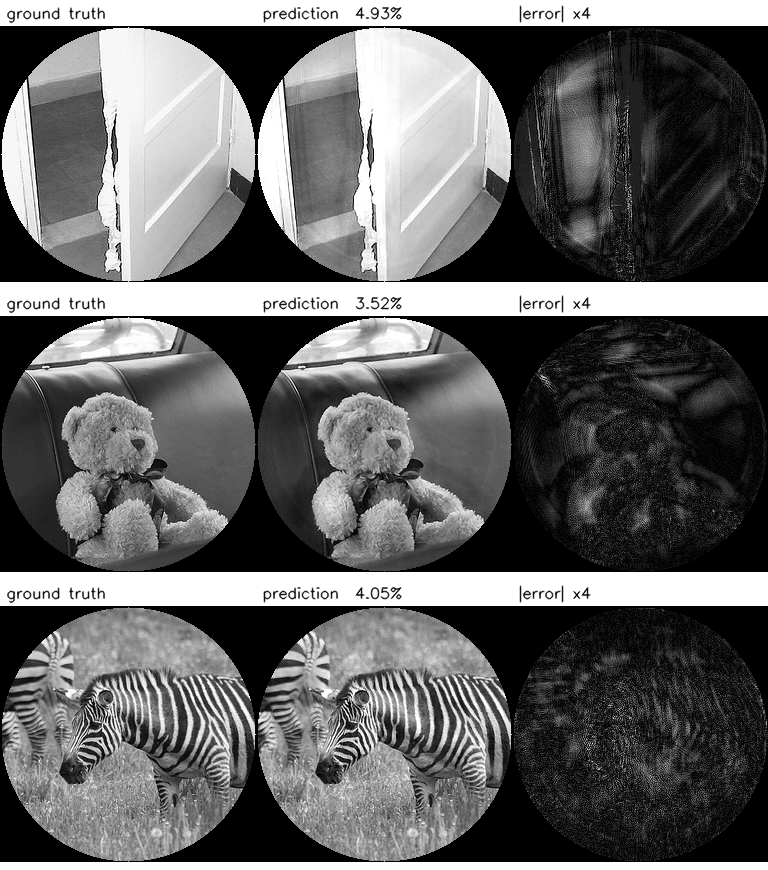 256×256 / 336 view 재구성. 왼쪽부터 정답, 예측, 오차×4
| 해상도 | 데이터 | RMSE | SSIM | PSNR |
|---|---|---|---|---|
| 64×64 / 128 view | 157,875장 | 1.618% | 0.987 | 37.04 dB |
| 256×256 / 336 view | 49,699장 | 3.971% | 0.938 | 28.40 dB |
얼룩말 줄무늬, 곰인형 털까지 복원됩니다. 다만 64×64 대비 오차가 2.5배입니다.
두 가지가 겹쳐 있습니다.
- 데이터가 3분의 1 — 256 crop이 가능한 COCO 영상이 49,699장뿐입니다 (64는 crop 256 후 축소라 157,875장)
- 학습을 13 에포크에서 중단 — 25 에포크 계획이었으나 도중에 멈췄습니다. 64는 80 에포크 중 62에서 최저값이 나왔으니, 256도 더 돌리면 내려갈 여지가 있습니다
512×512는 더 어렵습니다. COCO 158,957장 중 512 center crop이 가능한 게 6.9%인 11,137장뿐입니다. 짧은 변 중앙값이 427px이라 그렇습니다. 해상도를 올릴수록 데이터가 줄어드는 구조적 제약이 있습니다.
5. 재현 결과 다시 보기
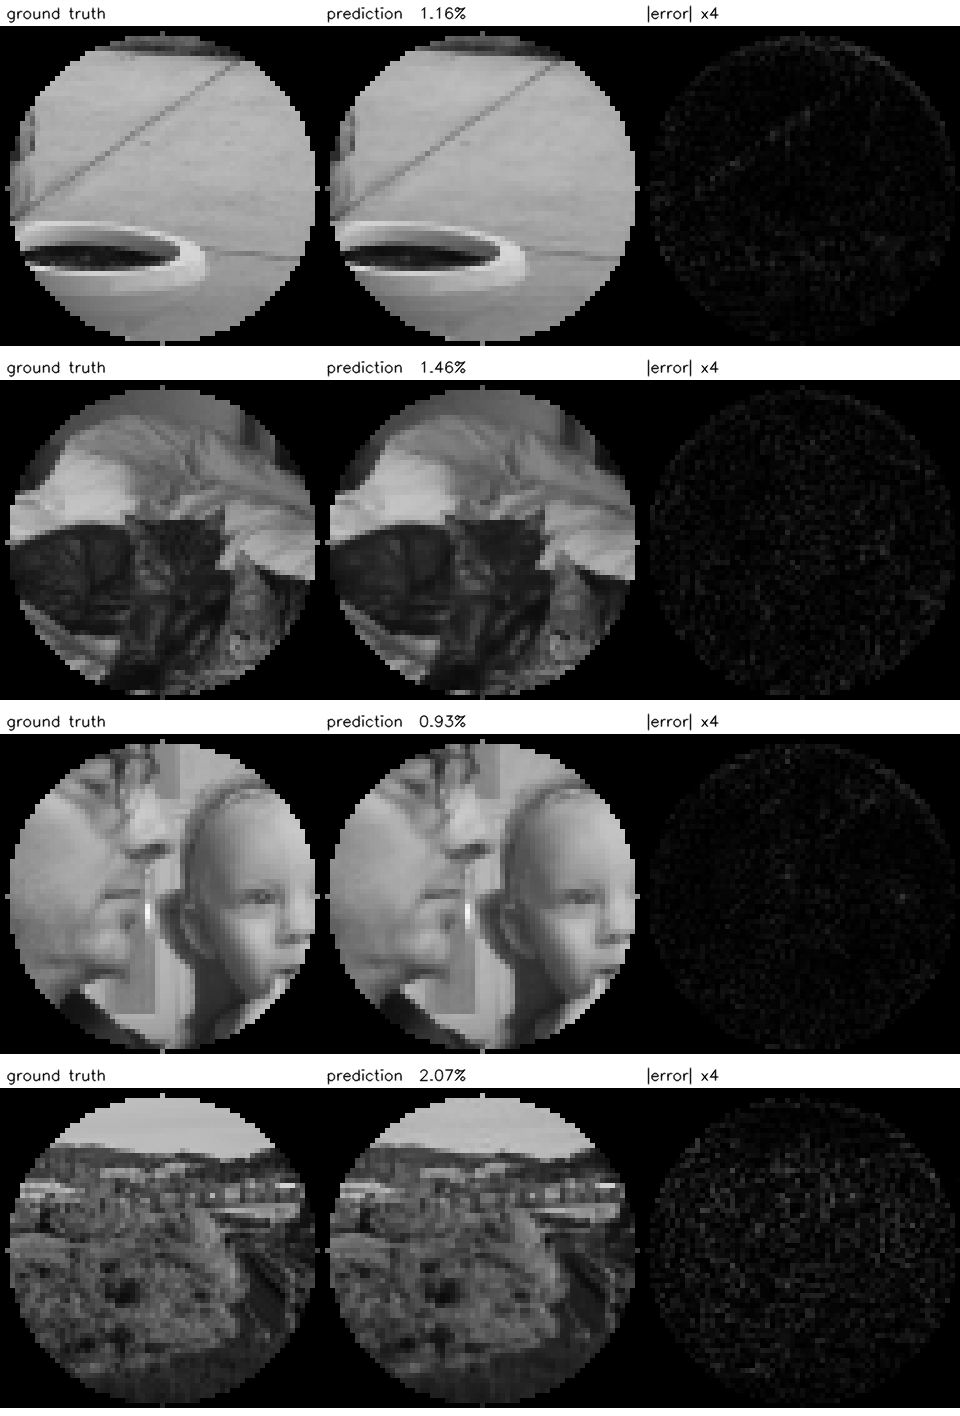 64×64 최종 결과. 오차 영상이 거의 검습니다
| RMSE | SSIM | PSNR | |
|---|---|---|---|
| 재현 | 1.618% | 0.987 | 37.04 dB |
| 포스터 | 1.556% | 0.983 | 36.60 dB |
SSIM과 PSNR은 넘었고 RMSE만 4% 차이입니다. 테스트셋 15,787장 기준입니다.
정리
세 축을 따로 재보고 나서야 순서가 보였습니다.
- 잡음 — 6배. 압도적입니다
- 데이터 — 275장에서 126,301장으로 늘리자 5 에포크 만에 이전 400 에포크 결과를 넘었습니다
- 구조 — 수용 영역을 따르되 영상 절반에서 포화합니다. 파라미터 수는 지표가 아닙니다
모델을 건드리기 전에 입력 데이터가 의도한 대로 만들어졌는지 확인하는 게 훨씬 빨랐을 것입니다. 원본 코드에 남아 있던 total_cnt_range = (2e5, 8e6) 한 줄이 답이었는데, 한참을 돌아왔습니다.
코드는 GitHub에 있습니다.