UMUD 챌린지 ④ — 0.325 → 0.271, 19등에서 6등으로: 화면마다 평가자의 좌표계가 달랐다
앞 글 이후 하루 동안 public 점수가 0.325 → 0.271이 됐고, 등수는 19등 → 335팀 중 6등이 됐습니다. 그런데 이 하루 동안 시도한 것은 대부분 실패했습니다. 점수를 크게 줄인 것은 새 모델이 아니었습니다. 화면 종류마다 평가자가 다른 좌표계에서 쟀다는 사실을 찾아낸 것이었습니다.
대회 진행 중이라 코드와 대회 이미지는 싣지 않습니다. 그림은 직접 그린 도식과 수치 차트입니다.
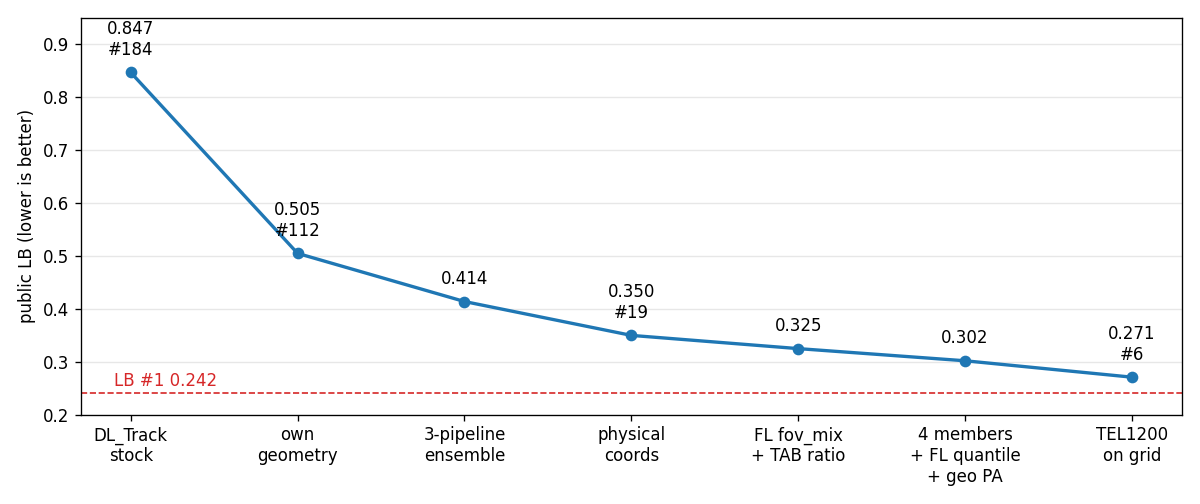 public LB (낮을수록 좋음). 각 점은 실제 제출 점수
| 단계 | public | 바뀐 것 |
|---|---|---|
| ③ 글 시점 | 0.350 | 세 모델 측정값 중앙값, 물리 좌표 |
| 0.325 | FL 후보 선택 규칙 수정, 태블릿 화면 비율 재추정 | |
| 0.316 | 방향 출력 모델을 네 번째 구성원으로 추가, 고전 PA 제거 | |
| ①번 절 | 0.302 | FL 분위수 항 + 기하 PA 한 표 |
| ③번 절 | 0.271 | TEL1200 화면만 늘려진 격자에서 측정 |
1. FL은 측정 규칙으로 고쳤다
근섬유다발 길이(FL)는 세 측정값 중 오차가 가장 컸습니다. 오차를 이미지별로 쪼개 보니 원인은 모델이 아니라 고르는 규칙이었습니다.
한 모델이 그린 다발 조각마다 근막 사이로 연장한 직선 후보가 이미지당 23개쯤 나옵니다. 이 중 정답에 가장 가까운 후보의 오차는 벤치마크 0.8~1.0mm, NeuAge 1.7~2.6mm였습니다. 정답이 후보 길이 범위 안에 들어 있는 비율도 91~97%였습니다. 후보 집합에는 정답이 있었고, 고르는 단계에서 틀린 것입니다.
정답이 후보 길이 분포의 어디쯤에 있는지 쟀더니 아래쪽에 몰려 있었습니다.
| 세트 | 정답의 후보 길이 분위 (중앙, IQR) |
|---|---|
| 벤치마크 35장 | 0.20 (0.14~0.32) |
| NeuAge 247장 | 0.33 (0.20~0.46) |
그래서 기존 선택값과 후보 길이의 0.25 분위수를 반씩 섞었습니다(fl_q=0.25). 새 조정값은 분위 하나뿐입니다. 0.22~0.28 사이에서는 결과가 거의 같았고, 한 세트에서 고른 값이 다른 세트에서도 좋아지는지 교차로 확인했습니다. 단일 파이프라인 17개(세트 × 모델)도 전부 좋아졌습니다.
여기에 기하 PA 한 표를 더했습니다. 세 값은 근사적으로 다음 관계를 따릅니다.
\[FL \cdot \sin PA \approx R \cdot MT\]정답에서 잰 $R$은 벤치마크 1.070, NeuAge 1.065였습니다. 평가자도 장비도 다른 두 세트가 같은 값을 냈습니다. MT가 셋 중 가장 정확하므로, $\arcsin(1.07 \cdot MT / FL)$를 PA 중앙값에 한 표로 넣으면 PA를 한 번 더 재는 효과가 납니다.
| 로컬 Δ (낮을수록 좋음) | 벤치마크 | 깨끗한 10장 | NeuAge |
|---|---|---|---|
| FL 분위수 항 | −0.0067 | −0.0002 | −0.0033 |
| + 기하 PA 한 표 | −0.0034 | −0.0045 | −0.0079 |
각각은 잡음 폭(표준오차 1배 안팎)과 비슷한 크기라서 하나만 보고는 믿지 않았습니다. 대신 모든 세트와 모든 단일 모델에서 같은 방향이라는 일관성을 근거로 채택했습니다. LB에서는 둘을 뺀 제출이 0.316, 넣은 제출이 0.302였습니다(−0.014). 로컬에서 예상한 −0.01 안팎과 같은 방향, 비슷한 크기입니다.
2. 하루 동안 실패한 것들
같은 날 시도한 것 대부분은 로컬에서 걸러졌습니다. 기준은 하나였습니다. 두 검증 세트가 모두 좋아져야 후보가 된다.
- 벤치마크 35장: 전문가 7명이 잰 공개 세트입니다. 다만 35장 중 25장은 대회 학습 세트에 같은 영상의 다른 프레임이 있어서 점수가 낙관적으로 나옵니다. 그래서 그런 사본이 없는 깨끗한 10장을 따로 봅니다.
- NeuAge 247장: 다른 장비(Esaote)와 다른 주석자로 만든 외부 세트입니다. 장비가 바뀌어도 통하는지 보는 용도입니다.
| 시도 | 결과 | 판정 |
|---|---|---|
| HRNet-w18 분할 모델 | 단독 벤치 0.175 (기준 모델 0.154), 앙상블에 넣으면 벤치 +0.011 | 기각 |
| 추가 데이터 + 다발 의사 라벨 | 단독 NeuAge 0.698 (기준 0.506), 앙상블 교체 시 NeuAge +0.046 | 기각 |
| 외부 데이터셋 FALLMUD 단독 학습 | 벤치 0.39~0.81, 다른 장비로 일반화 못 함 | 기각 |
| 대회 + FALLMUD 합본 학습 | NeuAge 0.708, 심층 근막을 놓쳐 두 근육 두께를 재는 경우 발생 | 기각 |
| Swin 계열 2종 (SwinUNETR, UPerNet-Swin) | 단독 벤치 0.170 / 0.176, 앙상블에 넣으면 악화 | 기각 |
| 다중 축척 TTA | 단일 모델은 개선, 앙상블에서는 벤치 +0.005~0.006 | 기각 |
| 휜 다발 곡선 추적 (경로·외삽) | 경로 추적 PA 벤치 +0.10~0.16, 외삽은 한 세트만 개선 | 기각 |
| MT 오인 규칙 (피하층을 근육으로 재는 경우 배제) | NeuAge −0.0075, 벤치에서는 발동 0회, NeuAge 반분 한쪽은 악화 | 보류 |
| 같은 모델 시드 추가 (2개) | 어떤 결합도 NeuAge 악화 (+0.006~+0.038) | 기각 |
마지막 줄에서 배운 것이 있습니다. 네 번째 구성원을 시드 1이나 2로 바꾸면 NeuAge가 0.014~0.028 나빠졌습니다. 시드 하나만으로는 각각 비슷한 모델인데도 그렇습니다. 지금 앙상블은 시드 0으로 학습한 모델을 보고 짠 것이라, 시드 0이 그 조합 안에서 운 좋게 잘 맞았던 셈입니다. 그 뒤로 새 구성원은 기존 시드 하나가 아니라 시드 평균과 비교합니다.
3. 축척 감사: 물리 근거와 점수가 엇갈렸다
③에서 테스트 이미지 239장이 가로로 늘려져 있고, 평가자는 늘림을 되돌린 원래 비율(phys)에서 쟀다는 것을 확인했습니다. 그때는 늘려진 화면 종류 세 가지를 한꺼번에 판정했습니다. 이번에는 화면 종류마다 따로 감사했습니다.
| 화면 | 장 | 물리 근거 |
|---|---|---|
| TAB (태블릿 프로브) | 58 | 이미 LB로 phys 확정 |
| S12L3 | 91 | phys로 잰 스캔 폭 5.10cm ↔ 프로브 사양 51.3mm (늘린 격자 그대로면 5.74cm, +12%) |
| TEL1200 | 90 | phys로 잰 스캔 폭 6.394cm ↔ 같은 장비의 정사각 화면 6.400cm, 다른 장비 6.409cm |
물리적으로는 세 종류 모두 phys가 맞습니다. 영상의 실제 모양은 의심할 여지가 없었습니다.
이상 신호
그런데 지난 LB 결과를 화면별로 나눠 보니 맞지 않는 데가 있었습니다. 화면 하나를 늘린 격자(grid)에서 phys로 바꿨을 때 예측값이 움직이는 크기로 얻을 수 있는 점수 이득의 상한을 계산하고, LB에서 실제로 얻은 이득과 비교했습니다.
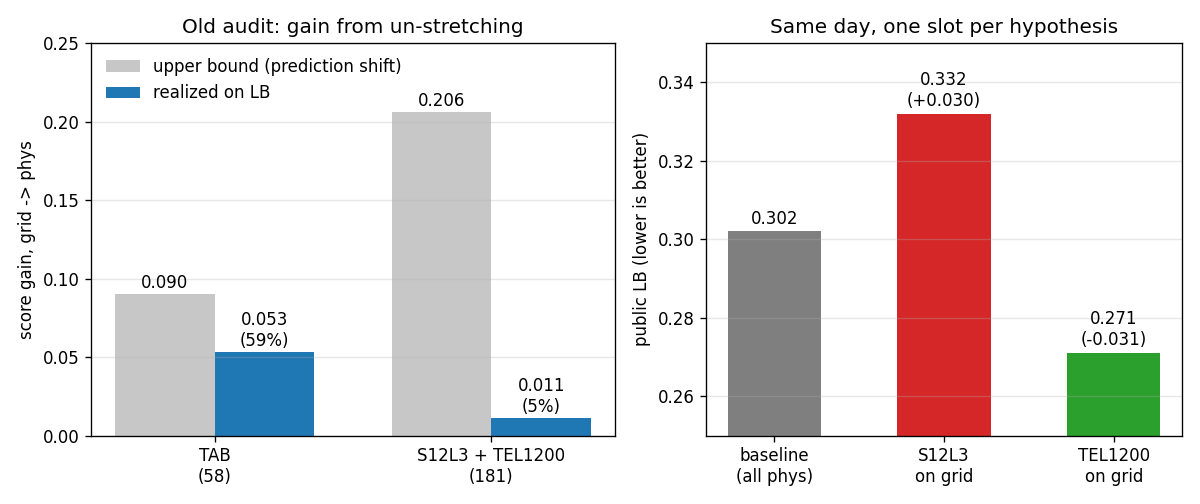 왼쪽: 지난 제출에서 grid → phys 전환의 상한 대비 실현 이득. 오른쪽: 같은 날 두 슬롯으로 한 판정
- TAB: 상한 0.090 중 0.053 실현 (59%)
- S12L3 + TEL1200: 상한 0.206 중 0.011 실현 (5%)
둘 다 phys가 정답이라면 이렇게 차이 날 이유가 없습니다. 측정 잡음을 넣은 간단한 모의실험에서도, 두 화면이 모두 phys라면 기대 이득은 0.06~0.11이었습니다. 실현값 0.011에 맞는 설명은 “한쪽은 grid, 한쪽은 phys”였습니다. 이득과 손해가 서로 상쇄됐다는 뜻입니다.
물리 근거가 말해 주는 것은 영상의 기하뿐입니다. 평가자가 어느 화면에서 쟀는지는 말해 주지 않습니다. 로컬에는 늘려진 영상이 하나도 없어서 이 질문은 LB에서만 판정할 수 있었습니다.
가설 하나당 제출 하나
기준 제출(0.302)에서 한 화면 종류만 grid로 바꾼 파일 두 개를 만들었습니다. 바뀌는 행은 각각 그 화면의 91장, 90장뿐입니다. 판정 규칙은 제출 전에 정해 뒀습니다. 기준보다 0.01 이상 좋아지면 grid를 채택하고, 0.02 이상 나빠지면 phys로 확정합니다.
| 제출 | public | 기준 대비 | 판정 |
|---|---|---|---|
| 기준 (전부 phys) | 0.302 | — | |
| S12L3만 grid | 0.332 | +0.030 | S12L3은 phys 확정 |
| TEL1200만 grid | 0.271 | −0.031 | TEL1200은 grid 채택 |
두 결과가 거의 같은 크기로 반대 방향이었습니다. 위의 “상쇄” 설명과 정확히 맞습니다. TEL1200의 영상 기하는 phys인데도, 이 화면의 평가자는 늘려진 화면을 그대로 보고 잰 것입니다. 장비나 뷰어 소프트웨어가 달랐기 때문으로 추정하지만, 확인할 방법은 없습니다.
이 판정 하나로 0.031이 줄었고, 하루 이득의 절반 이상이 여기서 나왔습니다. 모델은 한 줄도 바뀌지 않았습니다.
4. 검증 세트끼리 엇갈릴 때: UNet++ 방향 모델
같은 날 방향 출력을 붙인 UNet++(EfficientNet-B3) 모델도 학습했습니다. 결과가 두 세트에서 반대로 나왔습니다.
| 네 번째 구성원 교체 | 벤치마크 | 깨끗한 10장 | NeuAge |
|---|---|---|---|
| 기준 모델 → UNet++ | +0.006 (악화) | +0.004 (악화) | −0.027 (개선) |
NeuAge 이득은 표준오차 2~4배로 지금까지 본 것 중 가장 뚜렷했습니다. 시드 1·2로 다시 학습해도 재현됐습니다. 하지만 벤치마크 악화도 똑같이 재현됐습니다. 로컬만으로는 어느 쪽이 테스트에 맞는지 정할 수 없어서, 이것도 한 슬롯으로 물어봤습니다.
결과는 0.315로, 기준 0.302보다 0.013 나빴습니다. 벤치마크 쪽 신호가 맞았습니다. NeuAge는 장비가 하나(Esaote)뿐이고, 테스트에는 그 장비가 없는 것으로 보입니다. 장비가 바뀌어도 통하는지 보려고 둔 세트인데, 그 세트 하나에서 크게 좋아졌다는 사실만으로는 테스트에서도 좋아진다고 말할 수 없었습니다.
지금 위치와 다음
- public 0.271, 335팀 중 6등. 1위는 0.242, 2위는 0.257입니다.
- 늘려진 화면 종류는 모두 판정이 끝났습니다. TAB·S12L3은 phys, TEL1200은 grid입니다. 나머지 화면은 정사각이라 해당하지 않습니다.
- 다음은 다시 모델과 측정 쪽입니다.
- PA가 모든 장비에서 공통으로 작게 나옵니다. 오차를 나눠 보면 대부분 심층 근막 기울기에서 옵니다.
- Esaote 영상에서 심층 근막을 놓치는 문제는 규칙이 아니라 근막 모델에서 풀어야 합니다.
배운 것
- 물리 근거는 평가자가 무엇을 봤는지 알려 주지 않는다. 영상 기하와 정답의 좌표계는 다른 질문입니다. 둘을 구분하지 않았다면 “물리적으로 phys가 맞다”에서 멈췄을 것입니다.
- 상한 대비 실현 이득이 이상하면 거기에 뭔가 있다. 59% 대 5%라는 차이가 없었다면 TEL1200을 다시 볼 이유가 없었습니다.
- 가설 하나당 제출 하나, 판정 규칙은 제출 전에. 화면 하나만 바꾼 파일 두 개로 두 가설을 같은 날 따로 판정했습니다.
- 검증 세트끼리 엇갈리면 고르지 않는다. 한 세트에서 크게 좋아진 결과도 다른 세트에서 나빠지면 후보가 아닙니다. 엇갈린 결과는 LB에 물어볼 질문으로 남깁니다.
- 고른 시드는 운이 좋았던 시드일 수 있다. 기존 구성이 시드 0을 보고 짜였다면, 비교는 시드 평균으로 합니다.