UMUD 챌린지 ③ — 112등에서 19등으로: 측정값 앙상블과 '평가자는 어떤 화면을 봤나'
앞 글에서는 재는 방법만 바꿔 0.742를 0.505로 만들었습니다. 이번 하룻밤 사이에 0.505 → 0.350, 등수는 112등 → 19등이 됐습니다. 세 가지를 바꿨습니다.
대회 진행 중이라 코드와 대회 이미지는 싣지 않습니다. 그림은 직접 그린 도식입니다.
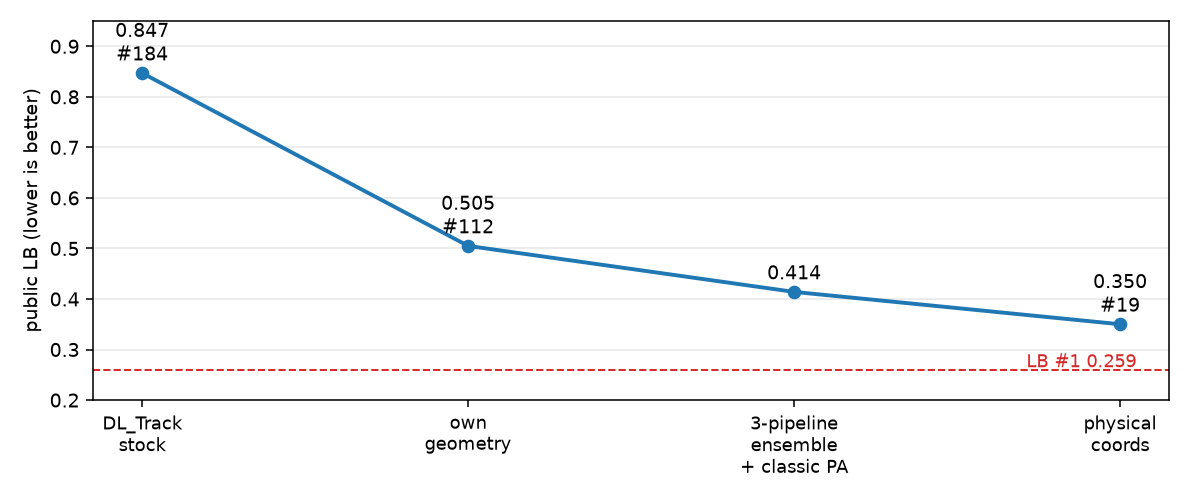 public LB (낮을수록 좋음)
1. 근섬유다발 방향은 모델과 고전 기법을 섞는다
근섬유다발 분할 라벨은 보이는 조각 일부만 칠해져 있습니다. 그래서 분할 모델의 Dice는 0.2 안팎에 머뭅니다. 점수에 필요한 건 모든 다발을 찾는 게 아니라 다발의 방향입니다. 그래서 근막은 모델로 찾고, 근섬유다발 방향은 원본 초음파에서 직접 재는 방법을 시험했습니다.
| PA 추정 (전문가 벤치마크 35장) | PA 오차 |
|---|---|
| 모델이 찾은 다발 조각 | 1.27° |
| 구조 텐서 | 1.73° |
| Gabor 필터 묶음 | 1.07° |
| ridge 강조 + 선분 검출 | 2.33° |
| Radon 투영 | 1.17° |
| 모델 · Gabor · Radon의 중앙값 | 0.94° |
혼자서는 어떤 고전 기법도 모델을 확실히 이기지 못했습니다. 가로로 긴 speckle과 평평한 격막에 끌려 각도를 작게 읽기 때문입니다. 그런데 오차의 상관이 0.2~0.26으로 낮아서, 셋의 중앙값을 쓰면 서로의 실수를 덮어 줍니다. 평균이 아니라 중앙값을 쓴 이유는, 테스트에서 한 방법이 가끔 혼자 크게 튀기 때문입니다(예: 11° 대 22~24°).
2. 앙상블은 확률이 아니라 측정값에서
분할 모델을 여러 개 만들었습니다. DL_Track, nnU-Net, 그리고 근막·근섬유다발 출력 둘을 가진 멀티태스크 U-Net입니다. 멀티태스크 모델은 라벨이 있는 출력만 손실을 계산해서 두 데이터셋 3,109장을 모두 씁니다.
이 모델들을 합치는 방법에서 예상 밖의 결과가 나왔습니다.
| 합치는 방법 (벤치마크 35장) | 점수 |
|---|---|
| 단일 최고 | 0.157 |
| 확률 맵 평균 후 측정 | 0.172 (악화) |
| 각자 측정한 뒤 PA·FL·MT 중앙값 | 0.144 |
가는 다발 확률을 평균하면 번져서 방향이 흐려집니다. 각 파이프라인이 끝까지 측정한 뒤 숫자를 합치는 쪽이 낫습니다.
35장으로는 0.02 아래를 못 믿는다
같은 설정으로 시드만 바꿔 다시 학습했더니 벤치마크 점수가 0.158과 0.177로 갈렸습니다. 벤치마크 35장에서 0.02 이하의 차이는 운입니다. 그 뒤로는 이렇게 정했습니다. 벤치마크는 명백한 손실을 거르는 데만 쓰고, 그보다 작은 차이는 리더보드 제출로 가린다.
3. 평가자는 어떤 화면을 보고 쟀나
첫 글에서 학습 이미지 64%가 가로세로 비율이 틀어지게 늘려져 있다는 걸 발견했습니다. 테스트도 309장 중 239장이 그렇습니다. 그런데 정답을 그린 평가자는 어떤 화면을 봤을까요?
- 늘려진 화면 그대로 봤다면, 늘려진 격자에서 재야 정답과 맞습니다.
- 원래 비율로 봤다면(또는 가로 축척을 따로 맞췄다면), 비율을 되돌린 뒤 재야 합니다.
비율이 바뀌면 각도가 바뀝니다.
\[\tan\theta' = \frac{s_y}{s_x}\tan\theta\]벤치마크에는 늘려진 이미지가 없어서 로컬에서는 판단할 수 없었습니다. 그래서 나머지는 모두 같고 이 가정만 다른 두 파일을 같은 날 제출했습니다.
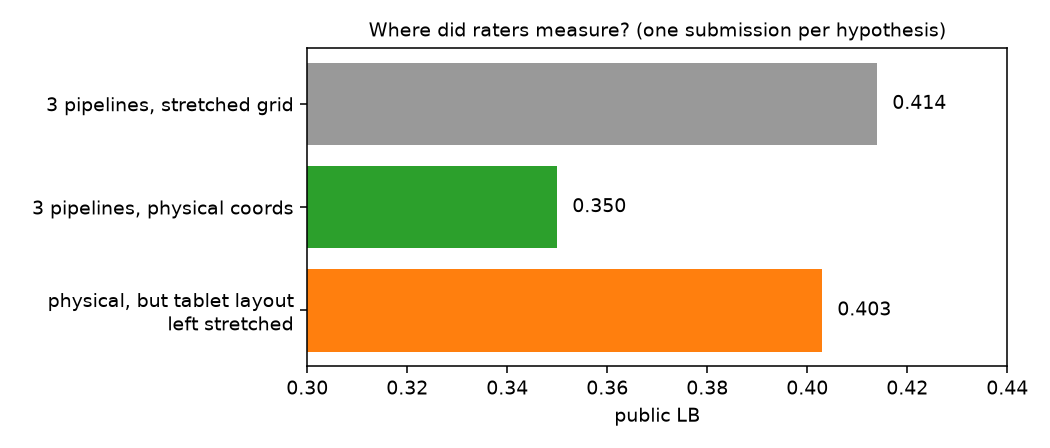 가설 하나당 제출 하나
| 제출 | public |
|---|---|
| 늘려진 격자에서 측정 | 0.414 |
| 원래 비율로 되돌려 측정 | 0.350 |
| 원래 비율, 단 태블릿 화면 58장만 늘려진 격자 | 0.403 |
답은 분명했습니다. 평가자는 원래 비율에 가깝게 쟀습니다. 세 번째 제출로 효과를 쪼개 보니, 0.064 개선 중 0.053이 태블릿 화면 58장에서 나왔습니다. 이 화면의 가로세로 비율(0.84)은 화면 구석의 둥근 배지가 세로로 1.19배 길쭉한 것에서 추정한 값이었습니다. 원래 둥글어야 할 아이콘 하나가 점수 0.05를 좌우한 셈입니다.
앞 글에서 저는 “평가자는 늘려진 화면에서 쟀을 것”이라고 추정했습니다. 틀린 추정이었습니다. 다만 그 추정을 그대로 믿지 않고 시험할 수 있는 형태로 남겨 둔 덕에, 제출 두 번으로 바로잡을 수 있었습니다.
지금 위치와 다음
- public 0.350, 330팀 중 19등. 1위는 0.259입니다.
- 같은 날 모델 다섯 개를 다 넣은 앙상블은 0.359로 약간 나빴습니다. 벤치마크에서 약했던 모델들이 섞였기 때문으로 봅니다.
- 다음 과제:
- 태블릿 화면의 비율을 배지 하나가 아니라 프로브의 실제 시야 폭으로 다시 추정
- nnU-Net 최종 체크포인트 반영
- 가장 큰 오차원인 FL 개선
배운 것
- 가정은 시험할 수 있게 남긴다. “주어진 격자에서 잰다”는 가정을 옵션 하나로 뒤집을 수 있게 짜 두었기에, 틀렸을 때 비용이 제출 두 번으로 끝났습니다.
- 효과를 쪼갠다. 한 번에 여러 개를 바꾸면 무엇이 효과였는지 모릅니다. 화면 유형 하나만 되돌린 제출이 개선의 83%가 어디서 왔는지 알려 줬습니다.
- 작은 검증 세트의 잡음 폭을 먼저 잰다. 시드만 바꿔 0.02가 흔들리는 걸 알고 나서야, 그보다 작은 개선에 매달리지 않게 됐습니다.