UMUD 챌린지 ⑤ — 0.271 제출 해부: 무엇이 점수를 만들었고, 다음엔 무엇을 실험할까
①~④는 하루 단위 기록이라, 지금 가장 좋은 제출이 어떤 부품으로 되어 있는지를 한 번에 보기 어려웠습니다. 이번 글은 그 정리입니다. public 0.27058(335팀 중 6등)을 낸 파이프라인을 처음부터 끝까지 한 장에 펼쳐 놓고, 각 부품이 LB를 얼마나 바꿨는지, 남은 오차가 어디에 있는지 적었습니다. 마지막에는 다음에 고를 수 있는 실험 메뉴를 붙였습니다.
대회 진행 중이라 코드와 대회 이미지는 싣지 않습니다. 그림은 직접 그린 도식과 수치 차트입니다. 이 글에서 ‘실측’은 다른 조건을 그대로 두고 한 가지만 바꾼 제출 쌍으로 확인한 값이고, 나머지는 ‘추정’입니다.
0. 한 장 요약
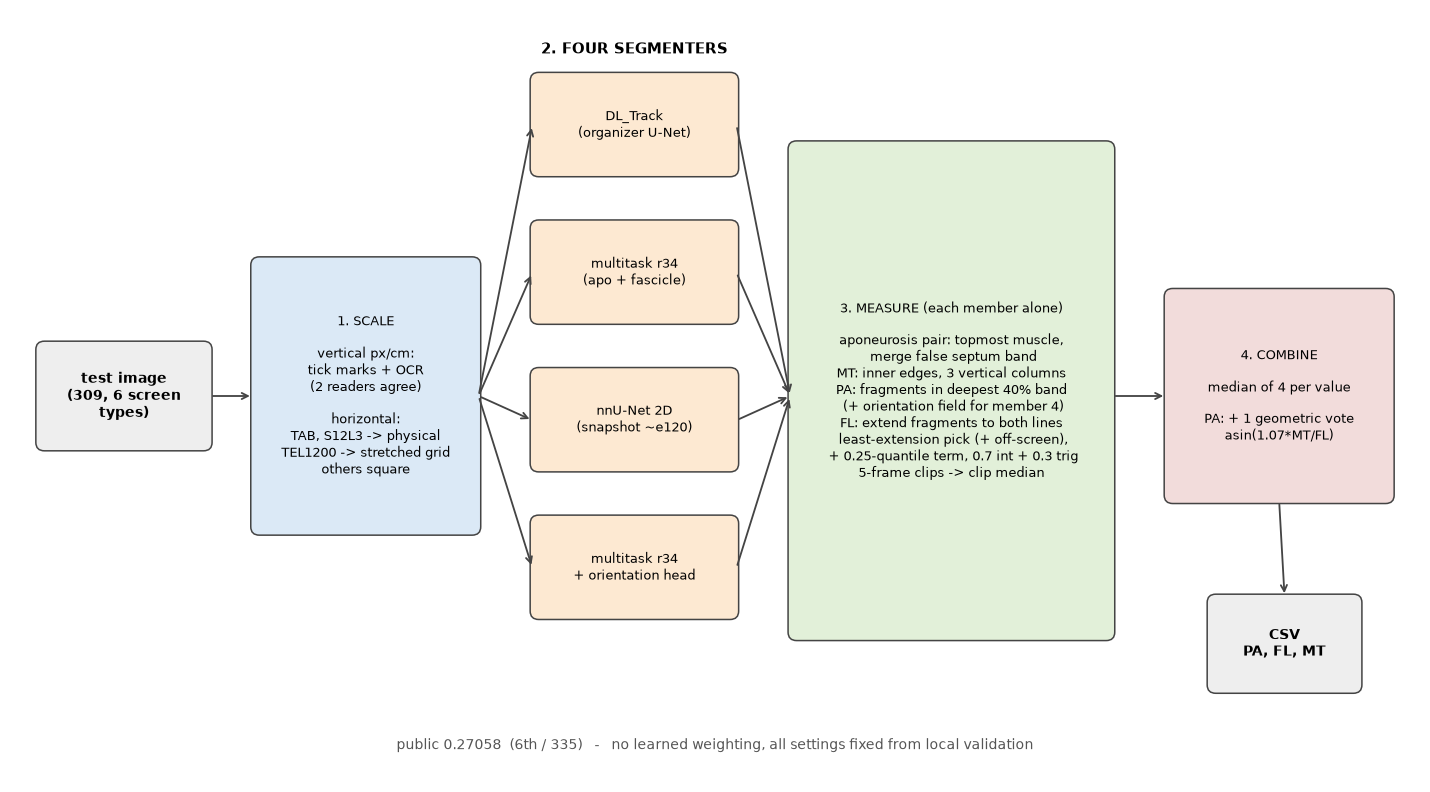 테스트 이미지 한 장이 숫자 세 개(PA, FL, MT)가 되기까지. 학습된 가중 결합은 없고, 모든 설정은 로컬 검증으로 정했다
과제를 다시 짧게 정리합니다. 근육 초음파 한 장에서 근섬유다발 각도(PA), 근섬유다발 길이(FL), 근육 두께(MT)를 맞힙니다. 학습 데이터에는 숫자 정답이 없고 근막·다발 분할 마스크만 있습니다. 그래서 파이프라인은 분할 → 기하 계산 → mm 변환 구조입니다. 점수는 세 MAE를 각각 6°, 12mm, 3mm로 나눠 평균한 값입니다.
\[S = \tfrac{1}{3}\left(\tfrac{\mathrm{MAE}_{PA}}{6^\circ} + \tfrac{\mathrm{MAE}_{FL}}{12\,\mathrm{mm}} + \tfrac{\mathrm{MAE}_{MT}}{3\,\mathrm{mm}}\right)\]정답은 평가자 2명이 변수마다 3번씩 잰 6개 측정의 평균입니다.
| 단계 | 하는 일 | 핵심 선택 |
|---|---|---|
| 1. 축척 | 픽셀을 mm로, 늘려진 화면은 되돌림 | 화면 종류별로 평가자가 본 좌표계를 따름 (TEL1200만 늘린 격자) |
| 2. 분할 | 근막·다발 확률 맵 | 성격이 다른 모델 4개, 확률 맵은 섞지 않음 |
| 3. 측정 | 모델마다 따로 PA·FL·MT | 평가자 측정 규칙을 흉내 냄 |
| 4. 결합 | 이미지마다 값별 중앙값 | PA에만 기하 관계로 구한 한 표 추가 |
1. 단계별로: 무엇을, 왜, 얼마나
1-1. 축척: 점수 이득이 가장 컸던 단계
무엇을. 세로 축척(px/cm)은 화면의 눈금 간격과 깊이 숫자(OCR)를 따로 읽어 서로 맞춰 봅니다. 화면 6종 전부에서 두 값이 최대 0.23% 안에서 일치했습니다. 테스트 309장 중 239장은 가로로 늘려진 화면입니다. 화면 종류별로 가로 축척을 따로 구합니다.
| 화면 | 장 | 가로 축척 근거 | 측정 좌표계 |
|---|---|---|---|
| TAB (태블릿 프로브) | 58 | 프로브 사양 FOV 34.5mm → 비율 0.8386 | 물리 좌표 (늘림을 되돌림) |
| S12L3 | 91 | 같은 화면 학습 마스크의 원 해상도 → 1.125 | 물리 좌표 |
| TEL1200 | 90 | 아래쪽 1cm 눈금 실측 | 늘린 격자 그대로 |
| TEL1088·GRAY853·CROP513 | 70 | 정사각 픽셀 | 해당 없음 |
왜. MT는 세로 방향이라 늘림의 영향을 받지 않지만, PA와 FL은 가로 축척에 그대로 흔들립니다. 늘림을 되돌리면 S12L3에서 PA가 약 1.9°, FL이 약 8mm 바뀝니다. 셋 다 물리적으로는 늘림을 되돌린 쪽이 맞았습니다. 그런데 TEL1200 평가자는 늘려진 화면을 그대로 보고 쟀습니다(④ 3절). 영상의 기하와 평가자가 본 화면은 다른 질문이었습니다.
LB에서 얼마나. 다섯 번의 실측 쌍이 모두 이 단계에 있습니다.
| 변화 | public | Δ | 근거 |
|---|---|---|---|
| 눈금 판독 수정 (91장) | 0.847 → 0.787 | −0.060 | 실측 |
| 늘림 되돌림 (TAB·S12L3·TEL1200 전부) | 0.414 → 0.350 | −0.064 | 실측 |
| 그중 TAB 58장 몫 | (TAB만 늘린 격자 0.403) | −0.053 | 실측 |
| TAB 비율 0.84 → 0.8386 | (fov_mix와 같이 제출) | ≤0.002 | 추정 |
| TEL1200만 늘린 격자로 되돌림 | 0.302 → 0.271 | −0.031 | 실측 |
| (기각) S12L3도 늘린 격자로 | 0.302 → 0.332 | +0.030 | 실측 |
모델을 한 줄도 바꾸지 않고 축척에서만 0.15 이상 줄었습니다.
1-2. 분할 모델 4개: 다양성은 측정값 단계에서 섞는다
| 구성원 | 정체 | 왜 넣었나 |
|---|---|---|
| DL_Track | 주최측 공개 U-Net(사전학습 가중치 그대로) | 다른 데이터로 학습된 시각, 오류 방향이 다름 |
| 멀티태스크 r34 | 인코더 하나 + 근막·다발 출력 두 개 | 근막 Dice 0.827, 근막 쪽 이득이 큼 |
| nnU-Net 2D | 1000 epoch 학습 중 약 120 epoch 시점의 스냅숏 | 근막이 가장 깨끗, NeuAge 단일 최고 |
| r34 + 방향 출력 | 위 모델에 다발 방향(2θ의 cos·sin) 출력 추가 | PA를 다발 조각이 아닌 방향장에서도 읽기 |
- 다발 라벨은 보이는 조각 일부만 칠해져 있어서 다발 Dice가 0.2 안팎에 머뭅니다. 점수에 필요한 건 다발 전체가 아니라 방향과 연장선이라, 이 정도로도 측정은 됩니다.
- 방향 출력은 라벨 조각 주변에서만 학습합니다. 라벨이 없는 곳은 “다발 없음”이 아니라 “모름”이기 때문입니다.
- 학습은 전부 fold 0 하나(학습 데이터의 약 80%)로만 했습니다.
- 확률 맵 평균은 오히려 나빴습니다. 두 모델의 확률 맵을 평균하고 재면 벤치 0.1719였는데, 모델마다 따로 재고 측정값 중앙값을 낸 세 모델 결합은 0.1444였습니다. 가는 다발 확률이 번지기 때문으로 추정합니다. 그래서 모델마다 끝까지 따로 재고 숫자만 합칩니다.
LB에서 얼마나. 모델 단계는 단독으로 판정한 적이 없습니다. 0.505 → 0.414(−0.091)는 3개 결합, 고전 PA, 근막 쌍 규칙 v2가 묶인 변화였습니다. 0.325 → 0.316(−0.009)도 방향 구성원 추가와 고전 PA 제거가 묶여 있습니다. 반대로 ‘더 넣기’는 실측으로 실패했습니다. 구성원 5개는 3개보다 +0.009, UNet++ 방향 모델로 바꾼 판은 +0.013이었습니다.
1-3. 측정: 평가자가 재는 방식을 그대로 흉내 낸다
이 단계의 원칙은 하나였습니다. 주최측이 밝힌 측정 방식에 맞춘다(②). 같은 DL_Track 분할에 이 기하만 새로 짜서 0.782 → 0.505(−0.277, 실측)가 됐습니다.
근막 쌍 고르기
- 화면 폭의 40% 이상 이어지는 띠만 근막 후보로 봅니다. 짧은 띠는 근육 안 격막일 가능성이 큽니다.
- 위아래로 이웃한 띠 쌍 가운데, 사이에 다발 신호가 충분한(최대치의 35% 이상) 가장 위쪽 쌍을 고릅니다. 두 근육이 보이면 평가자는 위쪽 근육을 잽니다. 벤치 16장과 NeuAge 37장에서 모두 확인했습니다.
- 바로 아래 칸에도 같은 각도(±4°)의 다발이 비슷한 양 있으면, 그 사이 띠는 가짜(격막)로 보고 두 칸을 합칩니다. 이 규칙이 없으면 MT가 10mm 짧게 나오는 영상이 생겼습니다.
MT
- 화면 왼쪽·가운데·오른쪽(1/6, 1/2, 5/6) 세로선 3개에서 표층 근막 아래 가장자리와 심층 근막 위 가장자리 사이를 잽니다.
- 근막 중심선끼리 재면 MT가 1.4mm 과대였습니다(벤치 0.190 → 0.320). MT는 mm당 점수가 가장 비싸서(1mm = 0.111점) 이 차이가 컸습니다.
PA
- 길이 0.25cm 이상이고 가늘고 긴 다발 조각만 씁니다.
- 근육 두께 중 심층 근막 쪽 40% 띠 안 조각의 각도를 심층 근막 기울기 기준으로 재고, 길이 가중 중앙값을 냅니다. 평가자가 다발이 심층 근막에 붙는 지점에서 각을 재기 때문입니다.
- 방향 출력 구성원은 이 값과, 근육 아래쪽 절반에서 다발 확률로 가중 평균한 방향장 각도의 중앙값을 씁니다.
- 원본 영상에서 직접 재는 고전 기법(Gabor·Radon)은 뺐습니다. 벤치의 이득은 학습 사본이 없는 10장에서는 사라졌고, 다른 장비 세트(NeuAge)에서는 오히려 나빠졌습니다(+0.025).
FL
- 다발 조각마다 자기 방향으로 두 근막까지 연장한 직선을 후보로 만듭니다. 이미지당 23개 안팎이 나옵니다.
- 후보 고르기는 세 겹입니다.
- ① 연장이 가장 적은 3개의 중앙값. 평가자도 연장이 최소인 다발을 고릅니다.
- ② 화면 밖으로 나간 비율 + 연장 비율이 가장 작은 3개의 중앙값. 평가자에게 ‘연장’은 보이지 않는 화면 밖 부분이기 때문입니다. ①과 ②를 반씩 섞습니다(fov_mix).
- ③ 그 값과 후보 길이의 하위 25% 분위수를 반씩 섞습니다(fl_q). 정답이 후보 분포의 아래쪽(분위 0.20~0.33)에 놓였기 때문입니다(④ 1절).
- 이렇게 고른 교점 길이 0.7과, 삼각 관계로 구한 MT/sin(PA) 0.3을 섞고 20~150mm로 자릅니다.
마무리
- 테스트에는 같은 영상의 연속 5프레임 묶음이 28개 있습니다. 묶음 안에서는 값마다 중앙값을 씁니다(0.787 → 0.782, −0.005 실측, 잡음 범위).
- 측정에 실패한 이미지는 같은 화면 종류의 중앙값으로 채웁니다. MAE에서는 극단값 한 장이 비싸기 때문입니다.
LB에서 얼마나. fov_mix는 0.350 → 0.325(−0.025)였습니다. TAB 비율 수정이 같이 묶였지만 그 몫은 ≤0.002로 추정해서, 사실상 fov_mix 몫입니다. fl_q는 기하 PA 한 표와 함께 0.316 → 0.302(−0.014)로 묶여 있습니다. 로컬에서 나눠 보면 fl_q −0.002~−0.007, 기하 PA ≤0.005 정도로 추정합니다.
1-4. 결합: 중앙값 + 기하 PA 한 표
- 네 구성원의 PA, FL, MT를 이미지마다 따로 중앙값으로 합칩니다. 넷의 중앙값은 가운데 두 값의 평균입니다.
- 평균은 한 구성원이 크게 튈 때 약했습니다(NeuAge +0.03~+0.04). 편향 보정은 장비를 바꾸면 따라오지 않았습니다(장비 하나 빼고 고른 보정이 벤치를 악화).
- PA에만 다섯 번째 표를 넣습니다.
1.07은 정답에서 잰 $FL \cdot \sin PA / MT$입니다. 벤치는 1.070, NeuAge는 1.065였습니다. 가장 정확한 MT를 이용해 PA를 한 번 더 재는 셈이라, 새로 조정한 값이 아닙니다.
1-5. 점수 기여 한눈에
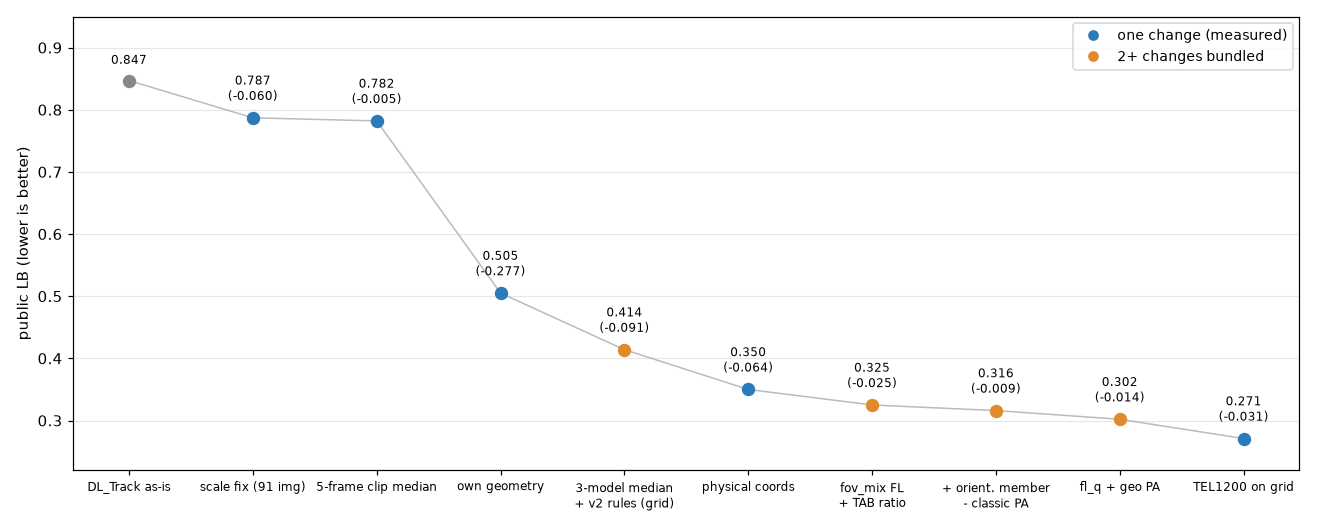 파란 점은 한 가지만 바꾼 실측, 주황 점은 두 가지 이상이 묶인 변화. 0.742(DL_Track에 벤치 편향 보정)는 자체 기하로 대체돼 빠졌다
| 부품 | LB Δ | 판정 |
|---|---|---|
| 축척: 눈금 판독 수정 | −0.060 | 실측 |
| 축척: 늘림 되돌림 (TAB 몫 −0.053) | −0.064 | 실측 |
| 축척: TEL1200은 늘린 격자 | −0.031 | 실측 |
| 측정: 자체 기하 (평가자 방식) | −0.277 | 실측 (같은 분할, 기하만 교체) |
| 측정: FL fov_mix | ≈ −0.023~−0.025 | 묶음 (TAB 비율과), 몫은 추정 |
| 측정·결합: fl_q + 기하 PA | −0.014 | 묶음, 나눈 몫은 추정 |
| 모델: 3개 중앙값 + 규칙 v2 + 고전 PA | −0.091 | 묶음 |
| 모델: 방향 구성원 추가 + 고전 PA 제거 | −0.009 | 묶음 |
| 클립 중앙값 | −0.005 | 실측 (잡음 범위) |
정리하면, 지금 점수의 대부분은 축척과 측정 규칙에서 나왔습니다. 모델 쪽 단독 이득은 LB로 따로 확인된 적이 없습니다. 이것이 다음 실험 메뉴를 고를 때 가장 중요한 사실입니다.
2. 남은 오차는 어디에 있나
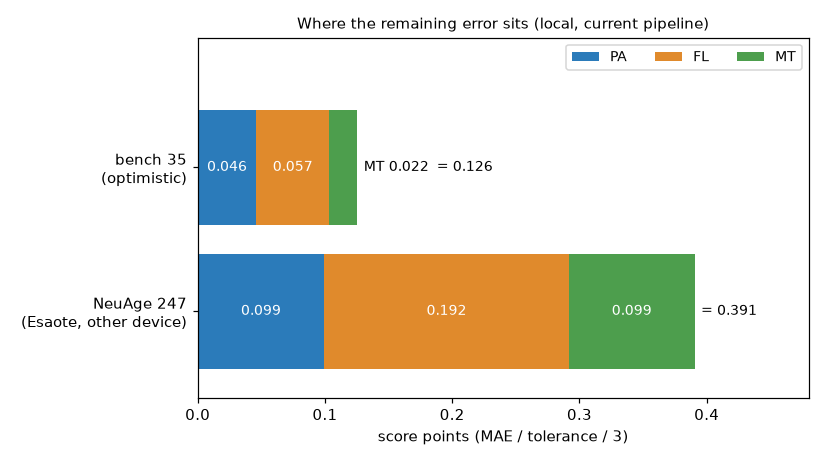 지금 파이프라인을 로컬 두 세트에서 채점해 항별로 나눈 값. 벤치는 학습 사본이 섞여 낙관적이다
LB 0.271은 벤치(0.126)의 두 배쯤입니다. 차이의 원인으로는 세 가지를 추정합니다. 벤치 35장 중 25장은 학습 세트에 같은 영상의 다른 프레임이 있습니다. 테스트 정답은 평가자 2명의 평균이라 평가자 관례 차이가 더 남습니다. 테스트의 S12L3·TAB 화면은 벤치에 없습니다. 그래서 항의 비중은 두 세트 사이 어딘가로 보고 읽습니다.
FL이 두 세트 모두 가장 큰 항입니다. 다만 문제는 ‘재기’가 아니라 ‘고르기’입니다.
- 구성원 하나의 후보 중 정답에 가장 가까운 것의 오차는 벤치 0.8~1.0mm, NeuAge 1.7~2.6mm입니다. 지금 오차는 2.1mm, 6.9mm입니다.
- NeuAge FL 오차를 나눠 보면 PA 오차가 번진 몫 42%, 화면 밖으로 긴 다발 39%, 근막 쌍·MT 실패 19%입니다.
- NeuAge 주석자는 휜 꺾은선을 그립니다. 정답 PA·MT를 그대로 넣은 삼각 관계로도 FL MAE가 8mm라, 직선 기하의 한계도 섞여 있습니다.
PA는 모든 장비에서 공통으로 작게 나옵니다.
- 편향은 벤치 −0.57°, 깨끗한 10장 −1.07°, NeuAge −0.72°입니다. 정답 PA가 클수록 더 작게 나옵니다.
- 네 구성원이 같은 쪽으로 틀린 이미지가 57~63%이고, 이들이 PA 오차의 82~84%를 차지합니다. 중앙값으로는 줄일 수 없는 오차입니다.
- NeuAge에서 다발 각과 근막 각을 나눠 보면, 음의 편향 대부분은 심층 근막 기울기에서 옵니다.
- 모델의 방향장은 심층 근막에 가까울수록 오히려 0.4~2.1° 평평해집니다. 짧은 조각일수록 평평합니다. 측정 규칙(띠 폭, 길이 가중, 곡선 추적, 근막 국소 접선)을 십여 가지 바꿔 봤지만 두 세트를 함께 개선한 것은 기하 PA 한 표뿐이었습니다. 이 편향은 모델 출력 쪽 과제로 판단합니다.
MT는 벤치에서는 거의 끝났고(0.20mm), 남은 것은 Esaote 근막 실패입니다.
- NeuAge에서 오차 10%가 넘는 22장이 MT 절대오차의 41%를 차지합니다. 22장 모두 Esaote 영상입니다.
- 유형은 피하층을 근육으로 잼 11장, 피부 띠를 표층으로 잡음 5장, 아래 근육 경계로 내려감 2장 등입니다.
- 원인은 심층·표층 근막을 아예 못 찾는 것이라 규칙으로는 막기 어렵습니다.
- UNet++ 방향 모델이 이 문제를 일부 잡아 NeuAge를 −0.027 개선했습니다. 그러나 LB는 +0.013이었습니다. 테스트에는 Esaote가 없는 것으로 보입니다(추정). 이 오차가 테스트 점수에 얼마나 들어 있는지부터 불확실합니다.
테스트에서 알려진 의심 사례
- TEL1088 클립 하나(5장)는 네 구성원 모두 PA 9.5°, FL 150mm(상한)로 일치합니다. 모델 문제가 아니라 영상 특성인지, 더 가파른 사선이 진짜 다발인지 아직 판정하지 못했습니다.
실패한 시도 (한 줄씩)
자세한 수치는 ④ 2절 표에 있습니다.
- 분할 모델 교체·추가
- HRNet-w18, SwinUNETR, UPerNet-Swin: 단독도 앙상블도 악화
- ResNet50 + 다발 배경 가중 1.0: 다발이 성겨져 FL 과대
- 추가 데이터 + 다발 의사 라벨: NeuAge 크게 악화
- FALLMUD 단독·합본 학습: 다른 장비로 일반화 못 함
- 같은 모델 다르게 쓰기
- 시드 추가·시드 평균: 지금 구성이 시드 0으로 짜여 있어 교체하면 악화
- 다중 축척 TTA, 좌우 반전 TTA: 단일 모델 이득이 앙상블에서 사라짐
- 확률 맵 평균: 측정값 중앙값보다 나쁨
- 측정 규칙
- 다발 곡선 추적: 화면 밖에서 평평한 꼬리로 연장돼 FL 과대
- PA 띠·길이 가중·근막 국소 접선: 한 세트에서 고르면 다른 세트에서 반대
- 편향 보정: 장비 간에 옮겨 가지 않음
- LB 실측으로 기각
- 구성원 5개 (+0.009)
- UNet++ 방향 구성원 (+0.013)
- S12L3 늘린 격자 (+0.030)
- 보류
- 다발 신호 하한으로 피하층 배제: 테스트에서 3행만 바뀜
- 짧은 조각 평평화 보정: 편향 이동에 가까워 집단 의존
3. 다음 실험 메뉴
판단 기준은 그대로입니다. 로컬 두 세트(벤치·NeuAge)가 모두 좋아져야 후보가 되고, 엇갈리면 LB 슬롯 하나로 묻습니다. 판정 문턱(보통 ±0.01)은 제출 전에 정합니다. 슬롯은 하루 5회, GPU는 서버 A6000 2장을 다른 작업과 나눠 씁니다. 기대 효과는 모두 추정입니다.
| # | 실험 | 가설 | 근거 | 자원 | 기대 효과 (LB) | 위험 |
|---|---|---|---|---|---|---|
| 1 | nnU-Net 최종 체크포인트로 교체 | 약 120 epoch 스냅숏보다 끝까지 학습한 모델이 근막·다발을 더 잘 찾는다 | nnU-Net이 NeuAge 단일 최고(0.450). 최종판 결과가 아직 기록되지 않은 미해결 과제 | 학습은 서버에서 진행 중(완료 확인 필요). 추론 309장 약 50분 + 로컬 두 세트, 슬롯 1 | 0 ~ −0.01 | 지금 앙상블은 스냅숏을 보고 짜였다. 시드 교체처럼 ‘더 좋은 단일’이 앙상블에선 나빠질 수 있다 |
| 2 | PA 과소를 모델 쪽에서 (방향 손실 개선) | 방향 출력이 짧은 조각·심층 근처에서 평평하게 학습됐다. 긴 조각 가중이나 심층 근처 가중 각도 손실로 줄일 수 있다 | 공통 음의 편향, 네 구성원 같은 부호, 방향장이 심층 쪽에서 0.4~2.1° 평평, 짧은 조각일수록 평평 | r34+방향 재학습 약 2.5시간 × 시드 2~3(시드 평균과 비교), 슬롯 1 | −0.005 ~ −0.015 | 편향 이동만 되면 집단 의존(청년 집단 악화 전례). 시드 잡음(벤치 0.02)에 묻힐 수 있다 |
| 3 | FL 후보 고르기 개선 (네 구성원 후보를 모아 한 번에 고르기 등) | 정답은 이미 후보 집합 안에 있다. 구성원별로 고른 뒤 중앙값을 내는 대신, 후보를 모아 고르면 선택 오차가 준다 | 최근접 후보 오차 0.8~2.6mm 대 현재 2.1~6.9mm. FL이 두 세트 모두 최대 항 | CPU만(후보 덤프 재조합 틀 있음), 통과 시 슬롯 1 | −0.005 ~ −0.015 | 조정값이 늘면 과적합. 한 세트에서 고르고 다른 세트에서 확인하는 교차 판정 필수 |
| 4 | 화면별 남은 편향 판정 (TEL1200 90장 위 fl_q·기하 PA 재확인 포함) | fl_q·R=1.07은 정사각·물리 좌표 화면에서 정했다. 늘린 격자로 재는 TEL1200(FL −9mm 이동)에서는 맞지 않을 수 있다 | 장비별 FL 편향이 다르다(벤치 Philips +2.85, Telemed −0.80). fl_q 화면별 평균 Δ는 TEL1200이 가장 크다(−0.65mm) | CPU, 슬롯 1~2 (TEL1200 행만 fl_q/기하 PA를 끈 판) | ±0.005 | public 중 TEL1200은 약 30장(추정)이라 잡음이 크다. public 과적합 위험, 문턱 ±0.01 미리 고정 |
| 5 | 근막 검출 강화 (밝기·게인·대비·스페클 증강, Esaote류 대응) | 심층·표층 근막을 놓치는 실패는 화질 차이 일반화 문제다 | NeuAge MT 오차 41%가 근막 실패 22장. UNet++가 일부 잡아 NeuAge −0.027 | r34 재학습 약 2시간 × 시드 2, 슬롯 1 | LB 0 ~ −0.005 (NeuAge는 큼) | UNet++ 전례: 테스트에 Esaote가 없으면 LB 무효과나 악화. 벤치가 나빠지면 같은 판정 반복 |
| 6 | UNet++ 방향 모델을 새 기준 위에서 재시험 (3시드 평균판) | 0.302 기준에서의 +0.013이 0.271 기준에서도 유지되는가 | 시드 1·2에서도 NeuAge 이득과 벤치 악화가 둘 다 재현됨. CSV는 축척표만 바꿔 다시 만들면 됨 | CPU, 슬롯 1 | 0 ~ +0.01 (악화 예상) | 슬롯 낭비 가능성이 크다. 가치는 비공개 테스트용 대비책 확인 정도 |
| 7 | 보류 규칙 LB 판정 (짧은 조각 평평화 보정 k=3 + 기하 PA) | 짧은 조각이 평평하게 나오는 몫을 보정하면 PA 과소가 준다 | 벤치 −0.008, 깨끗한 10장 −0.017, NeuAge −0.009. 단일 파이프라인 12/12 개선 | CPU, 슬롯 1 | −0.005 ~ −0.01 | 사실상 편향 이동이다. 편향이 작은 집단(NeuAge 청년)에서 악화 → 테스트 집단에 의존 |
| 8 | 의심 클립 점검 (TEL1088 5장 PA 9.5°·FL 150mm) | 평평한 조각을 고른 실패이고, 가파른 사선이 실제 다발이다 | 네 구성원이 똑같이 상한에 걸림. 삼각식으로는 약 170mm | 육안 검수(로컬) + 슬롯 1 | 0 ~ −0.01 (5장 FL이 크게 틀렸다면) | 근거가 단일 클립. 이미지별로 손대는 규칙은 일반화 근거가 약하다 |
| 9 | 전체 데이터·추가 fold 재학습 | fold 0(80%)만 쓴 모델에 나머지 20%를 더하면 좋아진다. 우승 시 재현 검사에도 필요 | Phase 1은 fold 0만 진행. Skeleton Recall도 미착수 | r34 계열 약 2시간 × 2모델, nnU-Net은 수일, 슬롯 1~2 | 0 ~ −0.01 | 시드 교체 실험처럼, 지금 앙상블은 지금 모델들을 보고 짰다. 교체가 악화로 나올 수 있다 |
| 10 | 최종 2개 선택 준비 | 비공개 약 207장에서 덜 흔들리는 조합을 미리 정한다 | public은 약 102장, 상위권 과적합 정황, LB 차 0.01 미만은 판별력 없음 | 슬롯 0 (로컬 정리) | 비공개 점수의 분산 축소 | 늦게 정하면 마지막 날 LB 숫자에 끌린다 |
권하는 순서(제 판단). 우선 1·3입니다. 둘 다 미해결 과제이고, 비용이 작거나 이미 돌고 있습니다. 다음은 2입니다. 남은 PA 오차의 대부분이 모델 쪽이라는 진단이 가장 단단합니다. 4·7·8은 슬롯이 남는 날 하나씩 묻고, 5·6은 테스트에 Esaote가 없다는 추정 때문에 뒤로 미룹니다. 9는 우승 재현 요건이라 마감 2주 전에는 시작해야 합니다.
4. 맺음: 최종 2개를 고르는 원칙
계획서(PLAN)의 원칙을 지금 상황에 맞춰 옮깁니다.
- 첫째 후보: 로컬 두 세트(벤치·NeuAge) 합산이 가장 좋으면서, public이 기준보다 나쁘지 않은 것. 지금이라면 0.271 구성입니다.
- 둘째 후보: 첫째와 ‘다른 쪽에 거는’ 구성. 고전 PA는 LB에서 단독으로 판정된 적이 없어서, 있음·없음 중 다른 쪽 최고 구성으로 장비 의존 위험을 나누는 것이 원래 계획입니다. TEL1200 늘린 격자 판정(−0.031)은 화면별 평가자 관례라 비공개에서도 유지될 가능성이 크다고 추정합니다. 그래서 이것을 갈라 걸 대상으로 보지는 않습니다.
- public 점수 차 0.01 미만은 고르는 근거로 쓰지 않습니다.
- LB 점수로 자동 가중하는 앙상블은 쓰지 않습니다. 대회 규정이고, 새 데이터에서 다시 돌릴 수 있어야 합니다.
지금까지 점수를 가장 많이 줄인 것은 새 모델이 아니라 “평가자가 무엇을 어떻게 쟀는가”를 맞춘 일이었습니다. 남은 큰 몫인 FL 고르기와 PA 과소도 같은 질문으로 시작해 보려 합니다. 평가자는 어느 다발을 골랐고, 어느 근막 선에 각도기를 댔는가.