PET 원리 ⑨ 정량화와 최신 흐름 — SUV, TOF, 그리고 딥러닝
8편까지 해서 PET 영상 한 장이 완성됐습니다. 마지막 편에서는 세 가지를 다룹니다. 완성된 영상의 값을 숫자로 읽는 법(SUV), 두 광자의 도착 시간 차이를 이용해 영상을 더 좋게 만드는 TOF, 그리고 딥러닝이 PET 파이프라인의 어디에 들어가고 있는지입니다.
PET 값은 밝기가 아니라 농도
7편에서 모든 보정과 교정을 거치면 PET 영상의 픽셀 값이 실제 방사능 농도(kBq/mL) 가 된다고 했습니다. CT의 HU처럼 물리적 의미가 있는 숫자입니다. 그런데 이 숫자를 그대로 환자끼리 비교하기는 어렵습니다.
- 환자마다 주사한 양이 다릅니다. 많이 넣으면 모든 곳이 진해집니다.
- 환자마다 체격이 다릅니다. 같은 양을 넣어도 체중이 많이 나가는 사람은 몸 전체에 더 묽게 퍼집니다.
SUV: 몸 전체에 고르게 퍼졌을 때와 비교
그래서 “이 조직에 모인 농도가, 주사한 방사능이 몸 전체에 고르게 퍼졌다고 가정했을 때보다 몇 배인가” 로 나타냅니다. 이것이 SUV(Standardized Uptake Value) 입니다.
\[\text{SUV} = \frac{\text{조직 농도 (kBq/mL)}}{\text{주사량 (kBq)} \;/\; \text{체중 (g)}}\]몸의 밀도를 물과 같은 1 g/mL로 보면 분모는 “고르게 퍼졌을 때의 평균 농도”가 됩니다. 그래서 SUV는 단위가 없는 비율입니다.
- SUV = 1: 딱 평균만큼 모였다.
- SUV = 5: 평균보다 5배 많이 모였다.
예를 들어 70 kg인 사람에게 350 MBq를 주사했다면, 고르게 퍼졌을 때의 농도는 350,000 kBq ÷ 70,000 g = 5 kBq/mL입니다. 어떤 병변의 농도가 25 kBq/mL로 측정됐다면 SUV는 5입니다. 주사량과 체중은 2편의 붕괴 보정을 적용해 같은 기준 시각으로 맞춘 값을 씁니다.
SUV는 영역에서 어떻게 뽑느냐에 따라 여러 종류가 있습니다.
| 지표 | 계산 방법 | 특징 |
|---|---|---|
| SUVmax | 관심 영역에서 가장 큰 픽셀 하나 | 가장 널리 쓰임. 재현성은 좋지만 잡음에 민감 |
| SUVmean | 관심 영역의 평균 | 영역을 어떻게 그리느냐에 따라 달라짐 |
| SUVpeak | 가장 뜨거운 곳 주변 1 cm³ 구의 평균 (PERCIST 기준) | SUVmax보다 잡음에 강함 |
SUV는 생각보다 많은 것에 흔들린다
SUV는 편리하지만 절대적인 숫자가 아닙니다. 같은 병변이라도 다음 조건에 따라 값이 달라집니다.
- 주사 후 촬영까지의 시간: FDG는 시간이 지날수록 병변에 더 쌓입니다. 60분에 찍느냐 90분에 찍느냐에 따라 SUV가 달라집니다.
- 혈당: 혈당이 높으면 FDG가 포도당과 경쟁해서 병변 SUV가 낮아집니다(1편).
- 재구성 조건: 반복 횟수, 후처리 필터, PSF 모델링에 따라 SUVmax가 크게 달라집니다(8편).
- 스캐너: 장비마다 해상도와 보정 방법이 다릅니다.
그래서 병원이 달라지거나 장비가 바뀌면 SUV를 직접 비교하기 어렵습니다. 여러 기관이 함께 연구할 때는 촬영과 재구성 조건을 표준화하는 가이드라인(EANM, EARL 인증 등)을 따릅니다.
작은 병변이 흐려 보이는 이유: 부분 용적 효과
SUV를 읽을 때 반드시 알아야 할 효과가 하나 더 있습니다. PET 해상도는 약 4 mm입니다(4편). 병변이 이 해상도와 비슷하거나 더 작으면, 영상에서 번져서 실제보다 옅어 보입니다.
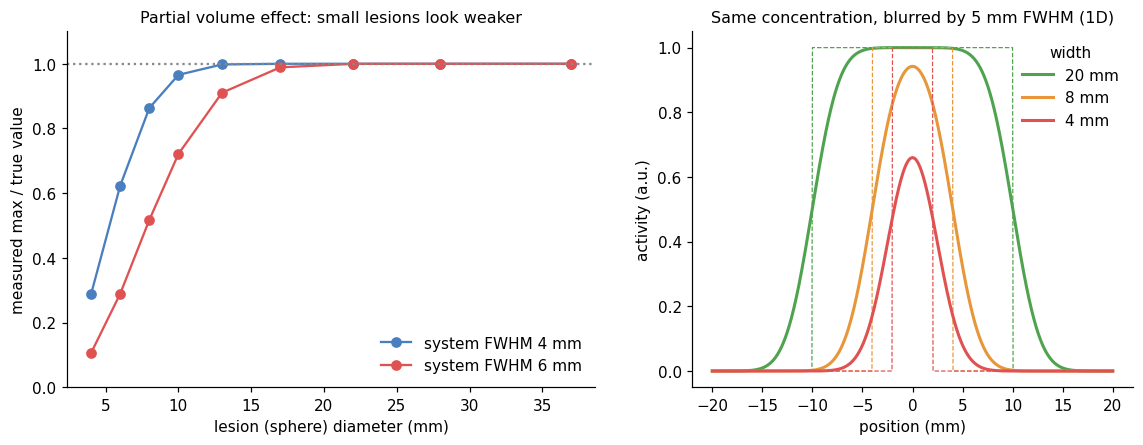 왼쪽: 구 모양 병변의 크기에 따라 측정된 최댓값이 실제 값의 몇 %인지(단순 가우시안 번짐 모형). 오른쪽: 같은 농도라도 폭이 좁을수록 번진 뒤 최댓값이 낮아집니다.
오른쪽 그림처럼 농도가 같아도 폭이 20 mm인 병변은 번져도 꼭대기가 그대로 남지만, 4 mm짜리는 옆으로 퍼지면서 꼭대기가 크게 낮아집니다. 이를 부분 용적 효과(partial volume effect) 라고 합니다.
왼쪽 그래프를 보면, 해상도(FWHM)의 2~3배보다 작은 병변은 SUV가 실제보다 낮게 측정됩니다. 해상도 6 mm인 장비에서 지름 6 mm 병변은 실제 값의 30% 정도로만 보입니다. 작은 병변의 SUV가 낮다고 “대사가 약하다”고 단정하면 안 되는 이유입니다.
부분 용적 효과는 반대 방향으로도 작용합니다. 뜨거운 장기 바로 옆의 영역은 번져 들어온 신호 때문에 실제보다 높게 보일 수 있습니다(spill-in).
TOF: 어느 쪽에 먼저 도착했나
지금까지 LOR은 “소멸이 이 직선 위 어딘가에서 일어났다”는 정보만 줬습니다. 그런데 검출기가 시각을 아주 정밀하게 잴 수 있다면(4편), 한 가지를 더 알 수 있습니다. 두 광자 중 어느 쪽이 먼저, 얼마나 먼저 도착했는가입니다.
소멸이 정중앙에서 일어나면 두 광자는 동시에 도착합니다. 한쪽으로 치우쳐 일어나면 가까운 쪽이 먼저 도착합니다. 그 시간 차이 \(\Delta t\)로 위치를 계산할 수 있습니다.
\[\Delta x = \frac{c \cdot \Delta t}{2}\]\(c\)는 빛의 속도(30 cm/ns)입니다. 2로 나누는 이유는 한쪽이 \(\Delta x\)만큼 가까워지면 다른 쪽은 그만큼 멀어져서, 경로 차이가 \(2\Delta x\)가 되기 때문입니다. 이렇게 비행 시간(time-of-flight) 을 이용하는 PET을 TOF-PET이라고 부릅니다.
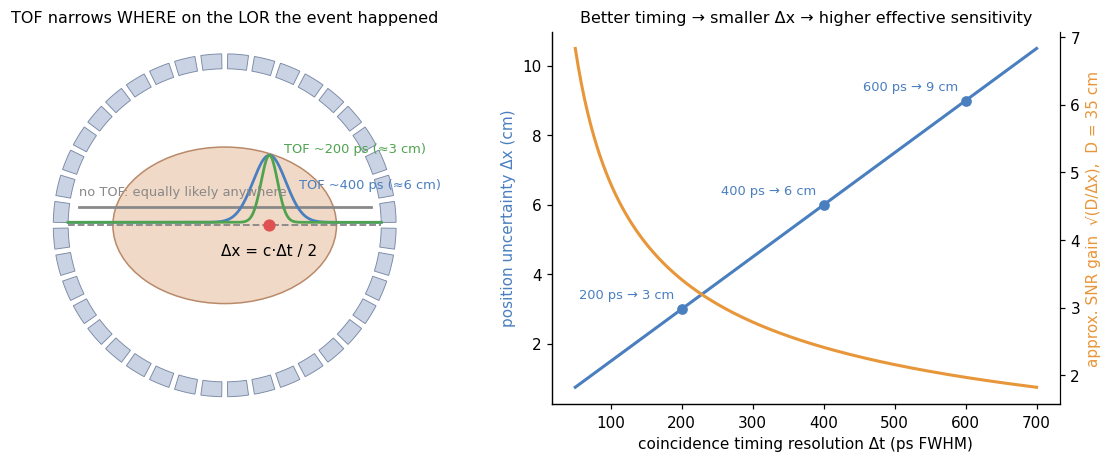 왼쪽: TOF가 없으면 소멸 위치는 LOR 위 어디든 같은 확률이지만, TOF가 있으면 좁은 구간으로 줄어듭니다. 오른쪽: 시간 분해능이 좋을수록 위치 불확실성이 줄고, 실질적인 감도가 올라갑니다.
시간을 재는 정밀도에는 한계가 있어서, 위치를 한 점으로 정하지는 못하고 구간으로 좁혀 줍니다. 시간 분해능이 400 ps면 약 6 cm, 200 ps면 약 3 cm 구간입니다(반치폭 기준). 몸 폭이 35 cm쯤이니, 소멸 위치의 후보가 몇 분의 일로 줄어드는 셈입니다.
TOF가 영상을 직접 선명하게 만들지는 않습니다. 해상도는 여전히 4편의 요소들이 정합니다. 대신 재구성할 때 잡음이 덜 퍼집니다. 원래는 LOR 전체에 나눠 칠하던 것을 좁은 구간에만 칠하니, 다른 곳에 섞여 들어가는 잡음이 줄어듭니다. 신호 대 잡음비가 대략 \(\sqrt{D/\Delta x}\)배 좋아지는데(\(D\)는 몸 폭), 이는 스캐너 감도를 그 제곱만큼 높인 것과 비슷한 효과입니다. 특히 몸이 큰 환자일수록 효과가 큽니다.
현재 임상 스캐너의 시간 분해능은 약 200~500 ps입니다. 연구 분야에서는 10 ps를 목표로 하고 있습니다. 10 ps면 위치를 1.5 mm 안으로 정할 수 있어서, 이론적으로는 재구성 없이 소멸 위치를 직접 찍을 수 있게 됩니다.
전신을 한 번에: Total-body PET
또 하나의 큰 흐름은 스캐너의 축 방향 길이입니다. 기존 PET은 링 묶음이 15~30 cm 길이라, 전신을 찍으려면 침대를 여러 번 옮겨야 합니다. 한 번에 몸의 일부만 보니, 나머지 부위에서 나오는 광자는 대부분 놓칩니다.
Total-body PET은 링을 약 2 m(첫 장비 uEXPLORER는 194 cm) 이어 붙여 몸 전체를 한 번에 덮습니다. 놓치던 광자를 대부분 잡으니 감도가 전신 촬영 기준으로 약 40배 높아집니다(Cherry 등, 2018). 이 감도를 어떻게 쓰느냐에 따라 가능해지는 것이 달라집니다.
- 주사량을 크게 줄이기: 소아나 반복 검사 환자의 피폭을 줄일 수 있습니다.
- 촬영 시간을 크게 줄이기: 수십 초 만에 전신을 찍을 수 있습니다.
- 전신의 동적 영상: 추적자가 온몸으로 퍼져 나가는 과정을 동시에 볼 수 있습니다.
딥러닝이 들어오는 자리
마지막으로 AI 연구자 입장에서 가장 궁금한 부분입니다. 딥러닝은 PET 파이프라인의 거의 모든 단계에 들어가고 있습니다.
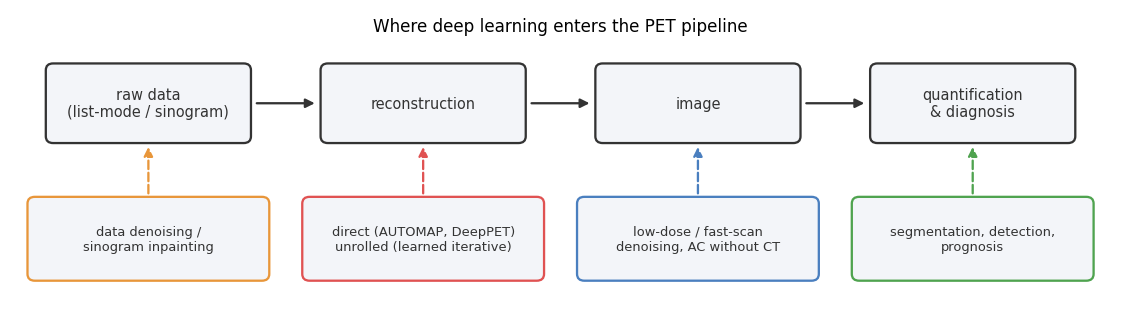 PET 파이프라인에서 딥러닝이 쓰이는 주요 지점
1. 영상 단계: 저선량·단시간 영상 복원
가장 활발한 분야입니다. 주사량이나 촬영 시간을 줄이면 계수가 줄어 잡음이 많아지는데(5편), 이 잡음 많은 영상을 정상 선량 영상처럼 복원하도록 학습합니다. 입력과 정답이 모두 영상이라 기존 영상 복원 기법(U-Net, GAN, diffusion)을 그대로 가져올 수 있습니다. 임상 제품으로도 나와 있습니다.
주의할 점은 PET 영상이 정량 영상이라는 것입니다. 눈으로 보기에 깨끗해져도 SUV가 달라지면 곤란합니다. 그래서 평가할 때 화질 지표뿐 아니라 SUV 보존 여부를 반드시 봅니다.
2. 재구성 단계: 사이노그램에서 영상으로
사이노그램을 입력으로 받아 영상을 직접 출력하는 방식입니다. 크게 세 갈래입니다.
- 직접 변환(direct): AUTOMAP, DeepPET 같은 모델이 사이노그램 → 영상 변환 전체를 학습합니다. 6편에서 봤듯이 영상의 한 픽셀이 사이노그램 전체에 퍼져 있으니, 완전 연결층이 필요하고 파라미터가 매우 많아집니다.
- 풀어 쓴 반복(unrolled): 8편의 반복 재구성 과정을 몇 단계로 펼치고, 각 단계의 일부(정규화 부분 등)를 신경망으로 바꿉니다. 순투영·역투영은 알려진 물리 연산을 그대로 쓰고, 모르는 부분만 학습합니다. 데이터가 적어도 잘 동작하고 결과를 설명하기 쉽습니다.
- 기하학을 넣은 직접 변환: 픽셀과 사이노그램의 대응 관계 \(r = x\cos\varphi + y\sin\varphi\)를 네트워크 구조에 직접 넣어, 이미 아는 관계를 굳이 학습하지 않게 합니다.
이 분야의 공통된 교훈은 “이미 아는 물리는 학습시키지 말고, 모르는 부분만 학습시켜라” 입니다. 순투영, 감쇠, Poisson 잡음은 수십 년 동안 정확하게 모델링돼 왔습니다. 이걸 네트워크가 데이터로부터 다시 배우게 하면 데이터와 파라미터만 낭비됩니다.
학습 데이터를 어떻게 만드느냐도 중요한 문제입니다. 실제 PET에는 정답 영상이 없기 때문입니다. 이전 글에서 일반 사진에 물리 모델을 적용해 (사이노그램, 영상) 쌍을 만드는 방법을 다뤘습니다.
3. 보정 단계: CT 없이 감쇠 보정
7편의 감쇠 보정에는 CT가 필요한데, CT는 추가 피폭입니다. 그리고 PET/MR에는 CT가 아예 없습니다. 그래서 MR 영상이나 보정 전 PET 영상으로부터 μ 지도(또는 가짜 CT)를 합성하는 연구가 활발합니다. 산란 추정을 신경망으로 빠르게 하는 연구도 있습니다.
4. 분석 단계: 분할, 검출, 예후 예측
재구성된 PET/CT 영상에서 병변을 자동으로 찾고 분할하거나, 전신의 종양 부피(MTV)나 총 병변 대사량(TLG)을 계산하거나, 치료 반응과 예후를 예측합니다. 일반적인 의료영상 AI와 가장 가까운 영역입니다. 다만 앞의 모든 단계, 특히 SUV가 흔들리는 요인들을 알고 있어야 모델이 기관이나 장비가 바뀌어도 버팁니다.
시리즈를 마치며
9편에 걸쳐 PET 영상 한 장이 만들어지는 과정을 따라왔습니다. 전체 흐름을 한 문장씩으로 되짚어 보면 이렇습니다.
- PET은 구조가 아니라 기능을 보는 방출 영상입니다.
- 추적자에 붙은 방사성 원자가 양전자를 내뿜습니다.
- 양전자가 전자와 만나 511 keV 감마선 두 개를 정반대로 내보냅니다.
- 섬광결정과 광검출기가 감마선을 시각·에너지·위치 정보로 바꿉니다.
- 동시에 맞은 두 검출기를 짝지어 소멸이 일어난 직선(LOR)을 얻습니다.
- 수억 개의 LOR을 사이노그램으로 정리합니다.
- 감쇠, 산란, 랜덤, 감도 차이를 보정합니다.
- 사이노그램에서 영상을 재구성합니다.
- 영상 값을 SUV로 읽고, TOF와 딥러닝으로 더 좋게 만듭니다.
영상을 다루는 입장에서 이 과정을 알아두면, 모델이 입력받는 영상이 이미 수많은 물리 가정과 알고리즘 선택을 거친 결과물이라는 점이 보입니다. 그 가정들을 알면 데이터의 이상한 점을 더 빨리 알아채고, 모델에 무엇을 맡기고 무엇을 맡기지 말아야 할지 판단할 수 있습니다.
참고문헌
- Boellaard R, Delgado-Bolton R, Oyen WJG, et al. FDG PET/CT: EANM procedure guidelines for tumour imaging: version 2.0. Eur J Nucl Med Mol Imaging. 2015;42:328–354. PMC4315529
- Wahl RL, Jacene H, Kasamon Y, Lodge MA. From RECIST to PERCIST: evolving considerations for PET response criteria in solid tumors. J Nucl Med. 2009;50(Suppl 1):122S–150S.
- Vandenberghe S, Mikhaylova E, D’Hoe E, Mollet P, Karp JS. Recent developments in time-of-flight PET. EJNMMI Physics. 2016;3:3. doi:10.1186/s40658-016-0138-3
- Cherry SR, Jones T, Karp JS, et al. Total-body PET: maximizing sensitivity to create new opportunities for clinical research and patient care. J Nucl Med. 2018;59(1):3–12. jnm.snmjournals.org
- Spencer BA, Berg E, Schmall JP, et al. Performance evaluation of the uEXPLORER total-body PET/CT scanner based on NEMA NU 2-2018 with additional tests to characterize PET scanners with a long axial field of view. J Nucl Med. 2021;62(6):861–870.
본문의 수치는 위 문헌과 대조해 확인했습니다. 그림은 모두 위 수치와 물리 식을 바탕으로 Python으로 직접 계산해 그린 것입니다.
PET 원리 시리즈