UMUD 챌린지 ① — 모델보다 데이터부터: 늘어난 초음파와 뒤집힌 팔레트
Kaggle의 UMUD Challenge: Muscle Architecture in Ultrasound Data에 참가하고 있습니다. 근육 초음파 한 장에서 숫자 세 개를 뽑는 대회입니다.
모델을 돌리기 전에 데이터를 먼저 봤습니다. 데이터가 틀리면 그 위에서 하는 연구는 전부 헛일이 되기 때문입니다. 실제로 봤더니 학습 이미지 절반 이상이 찌그러져 있었고, 마스크 일부는 뒤집혀 보였으며, 기준점으로 쓰려던 전문가 점수에도 오타가 섞여 있었습니다.
이 글은 그 확인 과정의 기록입니다. 대회 규정상 대회 데이터와 코드는 외부에 올릴 수 없어서, 그림은 전부 직접 그린 도식이고 코드는 싣지 않았습니다.
대회가 진행 중(마감 2026-11-14)이라 이 글은 아이디어와 수치만 담습니다. 코드와 실제 이미지는 대회가 끝난 뒤 따로 정리하겠습니다.
무엇을 맞히는 대회인가
다리 근육을 세로로 찍은 B-mode 초음파에는 세 가지 구조가 보입니다.
- 근막(aponeurosis): 근육 위아래를 감싼 막입니다. 밝고 굵은 띠로 보입니다.
- 근섬유다발(fascicle): 두 근막 사이를 비스듬히 잇는 희미한 줄무늬입니다.
- 그 사이의 근육 조직입니다.
여기서 세 숫자를 예측합니다.
| 변수 | 뜻 | 정답 측정 방식 (주최측 답변) |
|---|---|---|
| PA 우상각 (°) | 근섬유다발과 심층 근막 사이의 각 | 심층 근막에 붙는 다발 조각 3곳을 각도 도구로 측정 |
| FL 근섬유다발 길이 (mm) | 두 근막 사이 다발의 길이 | 연장이 가장 적게 필요한 다발 3개를 직선으로 이어 측정 |
| MT 근육 두께 (mm) | 두 근막 사이 수직 거리 | 이미지 왼쪽·가운데·오른쪽 세로선 3곳 |
정답은 평가자 2명 × 3회 측정의 평균입니다. 채점은 세 변수의 평균 절대오차를 허용오차(6°, 12mm, 3mm)로 나눠 평균한 값이고, 낮을수록 좋습니다.
\[S = \frac{1}{3}\left(\frac{\text{MAE}_{PA}}{6^\circ} + \frac{\text{MAE}_{FL}}{12\,\text{mm}} + \frac{\text{MAE}_{MT}}{3\,\text{mm}}\right)\]이 식에서 MT 1mm는 0.111점, PA 1°는 0.056점, FL 1mm는 0.028점입니다. mm당 비용은 MT가 FL의 네 배입니다.
까다로운 점은 학습 데이터에 이 숫자가 하나도 없다는 것입니다. 학습 데이터로 주어지는 건 근막 마스크 1,048장과 근섬유다발 마스크 2,761장뿐입니다. 그래서 자연스러운 길은 “분할 → 기하 계산 → 픽셀을 mm로 변환”입니다. 그렇다면 마스크와 이미지가 정확히 맞는지가 모든 것의 출발점이 됩니다.
발견 1 — 학습 이미지의 64%가 찌그러져 있다
이미지와 마스크의 크기를 전부 대조했더니 근막 1,048쌍 중 732쌍, 근섬유다발 2,761쌍 중 1,714쌍의 크기가 달랐습니다.
크기가 다른 쌍에는 패턴이 있었습니다. 이미지 쪽은 예외 없이 1200×800 하나였고, 마스크 쪽은 996×556, 1152×864, 660×556, 1340×810처럼 장비마다 다른 화면 해상도였습니다. 같은 장비라도 리사이즈되지 않은 원본이 섞여 있었는데, 그때는 이미지와 마스크 크기가 같았습니다.
즉 누군가 이미지만 1200×800으로 늘렸고, 마스크는 원래 해상도로 남았다는 뜻입니다. 종횡비를 무시하고 늘렸으니 픽셀이 정사각형이 아니게 됩니다.
추측만으로 넘어가지 않고, 화면에 찍힌 눈금으로 확인했습니다. 한 장비의 화면에는 세로로 0~50mm 눈금이, 아래쪽에는 가로 눈금이 있습니다.
| 세로 눈금 (10mm당) | 가로 눈금 (10mm당) | |
|---|---|---|
| 늘려진 1200×800 | 약 144 px | 약 120 px |
| 마스크 크기(996×556)로 되돌린 뒤 | 100 px | 100 px |
되돌리고 나서야 가로와 세로가 같아졌습니다. 원본은 마스크 쪽 해상도가 맞습니다.
왜 이게 치명적인가
비등방으로 늘리면 각도가 바뀝니다. 가로로 $s_x$배, 세로로 $s_y$배 늘리면 각도 θ인 선은 이렇게 보입니다.
\[\tan\theta' = \frac{s_y}{s_x}\tan\theta\]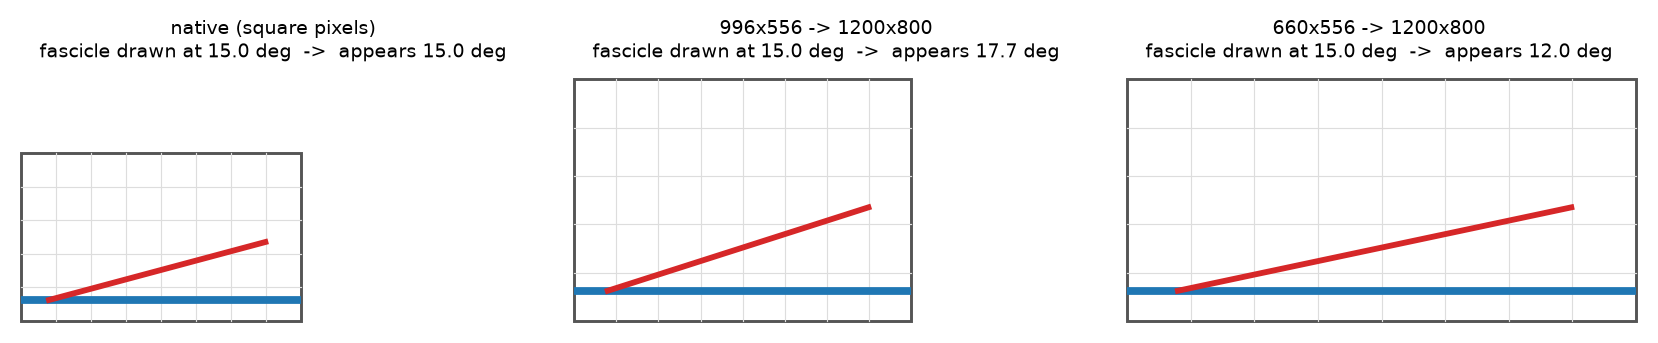 같은 15° 근섬유다발이 장비에 따라 12.0°~17.7°로 보인다 (직접 그린 도식)
| 원래 해상도 → 1200×800 | $s_y/s_x$ | 15°가 보이는 각도 |
|---|---|---|
| 996×556 | 1.194 | 17.7° |
| 1088×644 | 1.126 | 16.8° |
| 1340×810 | 1.103 | 16.5° |
| 1152×864 | 0.889 | 13.4° |
| 660×556 | 0.791 | 12.0° |
PA의 허용오차가 6°인데, 장비에 따라 ±3° 가까이 체계적으로 틀어집니다. 허용오차의 절반입니다. 이 상태로 분할 모델을 학습하고 각도를 재면, 모델이 아무리 좋아도 PA는 장비별로 편향됩니다. 길이도 가로와 세로 축척이 달라져서 FL과 MT에 같은 문제가 생깁니다.
그래서 이미지를 마스크 해상도로 되돌리는 전처리를 가장 먼저 했습니다. 줄일 때는 면적 평균, 키울 때는 bicubic으로 보간했습니다. 되돌린 이미지에 마스크를 겹쳐 보면 근막 선이 밝은 띠 위에 정확히 앉습니다.
남은 질문: 테스트 이미지 181장도 1200×800입니다. 테스트도 같은 방식으로 늘려진 것이라면, 평가자는 늘려진 이미지 위에서 각도를 쟀을 것입니다. 그렇다면 테스트에서는 오히려 되돌리지 않고 주어진 격자 그대로 재야 정답과 맞습니다. 학습은 원래 기하로, 추론은 평가자가 본 기하로. 지금 이 부분을 검증하고 있습니다.
발견 2 — 뒤집힌 줄 알았던 마스크
근막 마스크 474장의 전경 비율이 99%로 나왔습니다. 흰 배경에 검은 선이라 “반전된 마스크”처럼 보였습니다. 실제로 공개 노트북 몇 개는 이 474장을 뒤집어서 쓰고 있었습니다.
그런데 전처리를 다시 돌려 보니 반전된 마스크가 0장이었습니다. 원인은 파일 형식에 있었습니다.
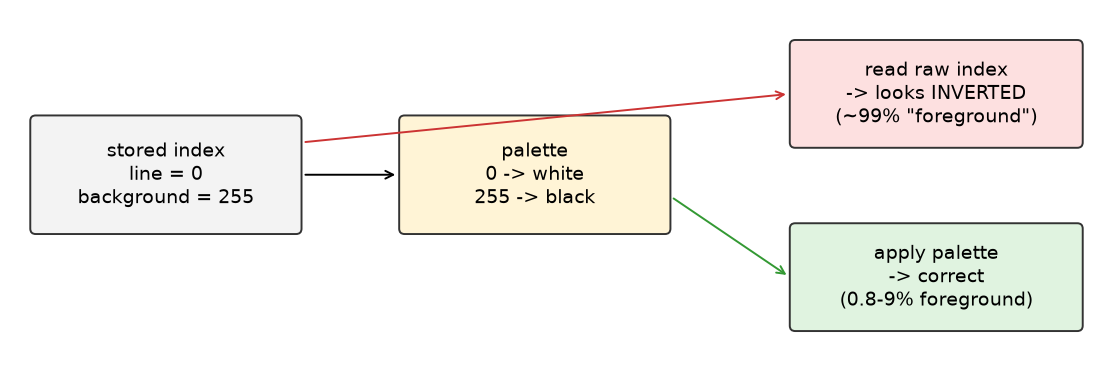 저장된 값은 인덱스이고, 실제 색은 팔레트가 정한다 (직접 그린 도식)
이 474장은 팔레트(P) 모드 TIFF입니다. 픽셀에 저장된 값은 색이 아니라 팔레트의 인덱스이고, 이 파일들은 팔레트가 거꾸로 되어 있습니다. 인덱스 0이 흰색, 255가 검은색입니다.
- 인덱스를 그대로 읽으면(배열로 바로 변환하면) 선이 0, 배경이 255로 나와서 뒤집힌 것처럼 보입니다.
- 팔레트를 적용해 회색조로 변환하면 정상입니다. 전경은 0.8~9.2%입니다.
결과적으로는 “뒤집어서 쓰기”와 같은 마스크가 나옵니다. 하지만 이유를 모른 채 뒤집으면, 팔레트가 정상인 다른 파일이 섞이는 순간 조용히 망가집니다. 증상이 아니라 원인을 고쳐야 하는 전형적인 사례였습니다.
발견 3 — 중복, 그리고 서로 다른 정답
근섬유다발 이미지 중 670장이 바이트 단위로 똑같은 사본이었습니다(24%). 주최측도 뒤늦게 공지했습니다.
이걸 그대로 두고 교차검증을 나누면, 같은 이미지가 학습과 검증 양쪽에 들어가 검증 점수가 부풀려집니다. 그래서 되돌린 이미지의 해시로 묶어 같은 이미지는 항상 같은 fold에 들어가게 했습니다. 고유 이미지는 근섬유다발 2,046장, 근막 1,028장입니다.
더 흥미로운 건 같은 이미지인데 마스크가 다른 경우였습니다. 근섬유다발에서 45그룹, 근막에서 20쌍 모두 그랬습니다. 같은 이미지를 두 번 라벨링한 흔적으로 보입니다. 라벨 자체에 사람 간 편차가 있다는 뜻이라, 이 쌍들은 모델이 도달할 수 있는 한계를 가늠하는 자료로 따로 보관했습니다.
발견 4 — 그 밖에 눈으로 봐야 보인 것들
숫자로 전수 검사를 한 뒤, 장비별로 이미지와 마스크를 겹쳐 놓고 직접 봤습니다. 숫자로는 안 잡히는 것들이 보였습니다.
- 좌우가 뒤집힌 이미지가 있습니다. 화면 글자가 거울상입니다. 마스크도 함께 뒤집혀 있어서 분할 학습에는 문제가 없지만, 근섬유다발의 기울기 방향이 섞여 있다는 뜻입니다.
- 라벨된 표층 근막은 가장 밝은 띠가 아닙니다. 한 장비의 화면에서는 맨 위 밝은 띠들이 피부와 그 아래 근막이고, 라벨은 그보다 아래 띠에 있습니다. “가장 밝은 두 줄 사이 거리”로 MT를 재면 틀립니다. 실제로 이 실수로 상수 제출보다 나쁜 점수를 받았다는 공개 저장소가 있었습니다.
- 모든 마스크는 보이는 조각만 라벨링되어 있습니다. 근섬유다발은 이미지당 평균 19개 조각이고, 픽셀의 0.3%밖에 안 됩니다.
발견 5 — 기준점에도 오타가 있었다
학습 데이터에 숫자 정답이 없으니, 개선을 재려면 외부 기준이 필요합니다. 주최측이 공개한 전문가 벤치마크 35장을 썼습니다. 전문가 7명이 같은 이미지를 각자 측정한 데이터입니다.
공개 저장소에서 인용되던 기준 점수는 “전문가 평균 0.303, 최고 전문가 0.246, DL_Track 0.331”이었습니다. 재현해 보니 정확히 같은 값이 나왔습니다. 그런데 overlay로 한 장씩 확인하다가 이상한 값이 보였습니다.
한 이미지에서 평가자 한 명의 MT가 80.1mm였습니다. 다른 평가자들은 모두 19.9~20.1mm였습니다. 명백한 입력 오타입니다.
이 값 하나만 빼고 다시 계산했습니다.
| 기준 | 원본 | 오타 제거 후 |
|---|---|---|
| 전문가 평균 (다른 6명의 평균 대비) | 0.303 | 0.249 |
| 최고 전문가 | 0.246 | 0.208 |
| DL_Track | 0.331 | 0.299 |
MT 허용오차가 3mm라서, 60mm짜리 오타 하나가 35장 평균을 크게 끌어올린 것입니다. 모두가 인용하던 “사람 수준”이 실제보다 0.05 나쁘게 알려져 있었습니다. 목표를 어디에 둘지가 달라지는 숫자입니다.
같은 검수에서 한 장비의 화면 축척이 눈금 실측보다 1~1.8% 작게 기록돼 있다는 것도 확인했습니다. MT로 치면 약 0.3mm입니다.
첫 제출: 기준선
전처리와는 별개로, 주최측 도구인 DL_Track을 그대로 돌려 첫 제출을 했습니다. 제출 파이프라인을 확인하고 기준점을 잡기 위해서입니다.
- public 0.847, 326팀 중 184등입니다. 1위는 0.259입니다.
- 태블릿 장비 이미지 58장 중 51장에서 근섬유다발을 못 찾았습니다.
- 축척을 읽는 규칙이 장비 하나에서 틀렸을 가능성이 보입니다.
덤으로, 주최측 샘플 제출 파일은 세미콜론 구분인데 채점기는 쉼표를 기대합니다. 샘플 형식 그대로 내면 “ID 열을 찾을 수 없다”는 오류가 납니다. 채점 함수로 직접 확인해 보니 BOM은 상관없었고, 구분자만 문제였습니다.
정리
| 확인한 것 | 규모 | 조치 |
|---|---|---|
| 이미지 비등방 리사이즈 | 학습 이미지의 64% (2,446 / 3,809) | 마스크 해상도로 복원, 눈금으로 검증 |
| 팔레트 반전 TIFF | 근막 마스크 474장 | 팔레트를 적용해 읽기 (반전 아님) |
| 바이트 동일 사본 | 근섬유다발 670장 | 해시로 묶어 같은 fold에 |
| 같은 이미지, 다른 마스크 | 65그룹 | 라벨 편차 자료로 보관 |
| 좌우 반전 이미지 | 다수 (집계 중) | PA 방향 처리 시 고려 |
| 기준 점수의 오타 | 60mm 오타 1건 | 사람 수준 0.303 → 0.249 |
이 작업에서 모델은 하나도 학습하지 않았습니다. 그래도 PA에서 ±3°, 기준점에서 0.05가 오갔습니다. 앞으로 모델을 바꿔서 얻을 개선폭이 이 정도일 겁니다.
다음 글에서는 테스트 이미지의 축척을 장비별로 읽어내는 일과, 분할 모델을 학습시킨 결과를 다루겠습니다. 이 대회의 점수는 결국 mm를 정확히 재는 것에서 갈릴 것 같습니다.